 悩んでる人
SFT、LoRA、DPO…結局何がどう違うの?
 情シス あおい
更新するパラメータの範囲と、教師にするデータの種類で分かれます。
ファインチューニングには、SFT・フルファインチューニング・LoRA・QLoRA・RLHF・DPOという6つの手法があります。
名前は似ていても、何を更新し、何を教師にするかはまったく違います。
とはいえ、この違いを正面から整理した記事は意外と見当たりません。
そこで、公式の論文・ドキュメントをもとに、6手法を2つの軸で整理しました。
今回は、6手法の違いとローカルで回すときの選び方を紹介します。
- SFT・フルFT・LoRA・QLoRA・RLHF・DPOが、何を更新し何を教師にするかという2軸
- SFTとDPOが、データの作り方からそもそも違うという点
- Unsloth・LLaMA-Factory・Axolotl・MLXでローカルで回す場合の選び方
先に早見表だけ確認したい方は6手法を2つの軸で整理するからどうぞ。
※ライセンス・バージョン・数値の確認日は、すべて2026年10月時点のものです。
ファインチューニングの種類|6手法を2つの軸で整理する
ファインチューニングの種類は、「何を更新するか」と「何を教師にするか」の2軸で整理できます。6手法は、この2軸の組み合わせで位置が決まります。
何を更新するか|フルファインチューニングとPEFT
フルファインチューニングは、モデルの全パラメータを更新します。
一方、PEFT(Parameter-Efficient Fine-Tuning)は、一部のパラメータだけを更新します。
Hugging Face公式のPEFTドキュメントにも、この軸がそのまま定義されています。
全パラメータを再学習しないぶん、計算コストとストレージを大きく抑えられると公式は説明しています。
LoRAやQLoRAは、このPEFTに含まれる手法です。
何を教師にするか|正解例(SFT)と好み(RLHF・DPO)
SFTは、「こう答えてほしい」という正解例を教師にします。
RLHFとDPOは、2つの回答のどちらが好ましいかという好みを教師にします。
Hugging Face TRL公式のデータセット形式のドキュメントにも、この違いがそのまま定義されています。
SFTTrainerはprompt-completion型、DPOTrainerはchosen/rejected型のデータを使います。
6手法の早見表
2つの軸に沿って、6手法を1つの表にまとめました。
| 手法 | 何を更新するか | 何を教師にするか | 代表的なTrainer |
|---|---|---|---|
| SFT | 全体またはPEFT併用 | 正解例 | SFTTrainer |
| フルファインチューニング | 全パラメータ | 正解例・好みいずれも可 | 専用Trainerなし(※) |
| LoRA | 低ランク行列(PEFT) | 正解例が中心 | SFTTrainer+LoRA |
| QLoRA | 低ランク行列+4bit量子化(PEFT) | 正解例が中心 | SFTTrainer+QLoRA |
| RLHF | 方針により異なる | 好み(報酬モデル経由) | GRPOTrainer/RLOOTrainer等 |
| DPO | 方針により異なる | 好み(ペア比較) | DPOTrainer |
※フルファインチューニングには専用のTrainerがなく、SFTTrainer等の設定で全パラメータを学習対象にして実現します。
SFT(教師ありファインチューニング)とは|公式が示すデータ形式
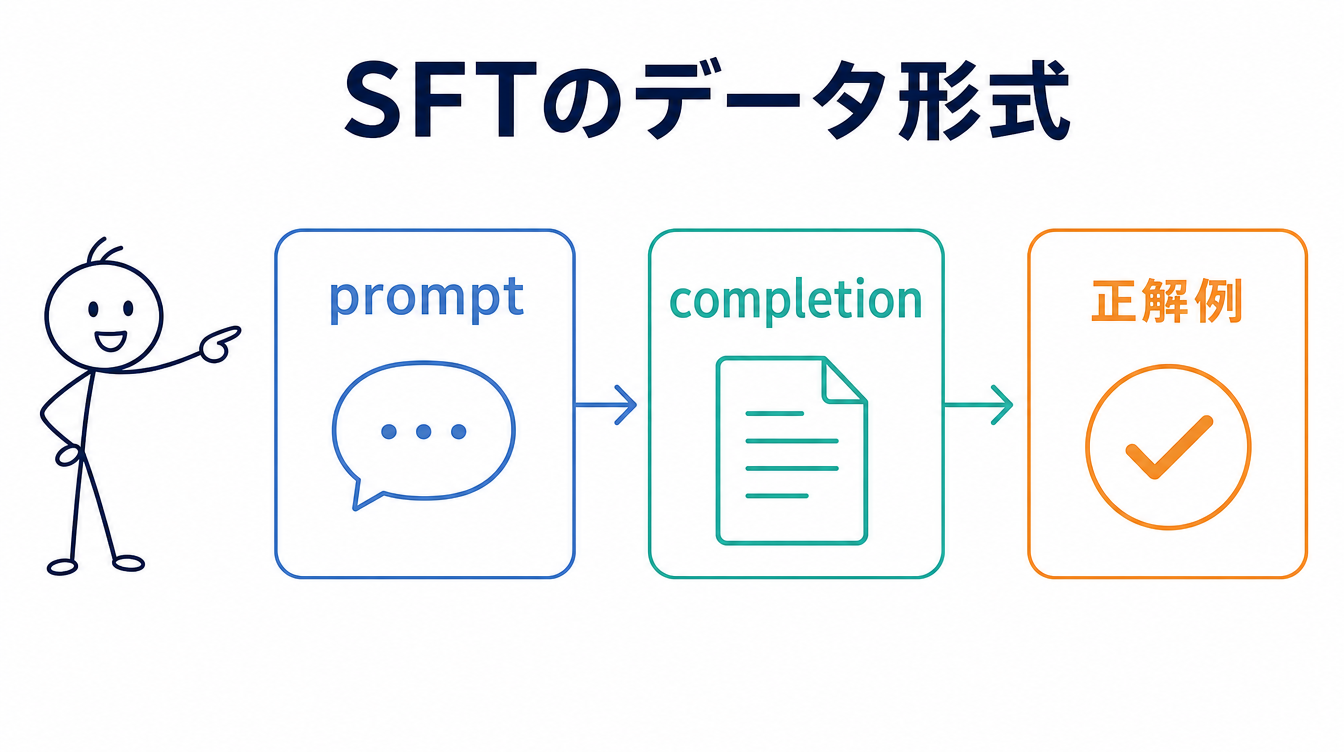
SFT(Supervised Fine-Tuning)は、正解例をそのまま覚えさせる学習方法です。
prompt-completion形式というデータの作り方
悩んでる人SFTって結局、何を用意すればいいの?
情シス あおいプロンプトと、その理想の回答のペアだけです。
Hugging Face公式のSFTTrainerドキュメントは、promptとcompletionのペア形式を扱うと定義しています。
文章全体を学習させるlanguage modeling形式も使えますが、prompt-completion形式の方が意図が明確になります。
正解そのものを用意できるタスクほど、SFTが向いています。
フルファインチューニングとの関係
SFTは「何を教師にするか」の話で、フルFTは「何を更新するか」の話です。
つまり、全パラメータを更新しながらSFTを行うことも、LoRAでSFTを行うことも両方できます。
「フル」であることを強調する独立の定義は公式には見当たらず、PEFTとの対比で初めて輪郭がはっきりします。
PEFTの内訳|LoRA・QLoRA以外にもある選択肢
PEFTには、LoRA・QLoRA以外にも複数の手法があります。
LoRAの仕組み|低ランク行列で一部だけ更新する
LoRA(Low-Rank Adaptation)は、事前学習済みの重みを凍結し、低ランク行列だけを学習します。
LoRAの論文は、GPT-3 175Bのフルファインチューニングとの比較を示しています。
学習対象パラメータを1万分の1、GPUメモリ要件を3分の1に減らせると報告されています。
ただし、これはGPT-3 175Bを前提にした相対比較という条件つきの数字です。
絶対的なGB数値は、論文の要旨には記載されていません。
QLoRAの仕組み|量子化とLoRAの組み合わせ
QLoRAは、4bit量子化したモデルにLoRAアダプタを組み合わせる手法です。
QLoRAの論文は、65Bパラメータのモデルを単一の48GB GPUでファインチューニングできたと報告しています。
4bit量子化と、量子化定数自体を量子化する工夫の組み合わせが条件です。
| 手法 | 削減対象 | 条件 | 報告されている数値 |
|---|---|---|---|
| LoRA | 学習パラメータ・GPUメモリ | GPT-3 175BのフルFT比 | パラメータ1万分の1・メモリ3分の1 |
| QLoRA | GPUメモリ(量子化併用) | 65Bモデル・4bit量子化 | 単一48GB GPUで学習可能 |
なお、ここでのVRAMは学習時の数値で、推論時に必要なVRAMとは別物です。
普段使うモデルのVRAM目安を先に確認したい方は、VRAM別に動かせるモデル一覧も参考にしてください。
DoRA・IA3・Prefix Tuningという他の選択肢
PEFTには、LoRA・QLoRA以外の手法も数多くあります。
Hugging Face公式のPEFTドキュメントは、代表的な手法としてDoRA・IA3・Prefix Tuningなどを挙げています。
Prompt Tuningなど、名前の似た手法も別途列挙されています。
DoRAはLoRAの派生版で、AdaLoRA・LoHa・LoKrなど多数が公式に列挙されています。
本記事では全体の分類に絞り、個別手法のさらに深い比較はここでは扱いません。
ファインチューニングの選好学習|RLHFとDPOの違い
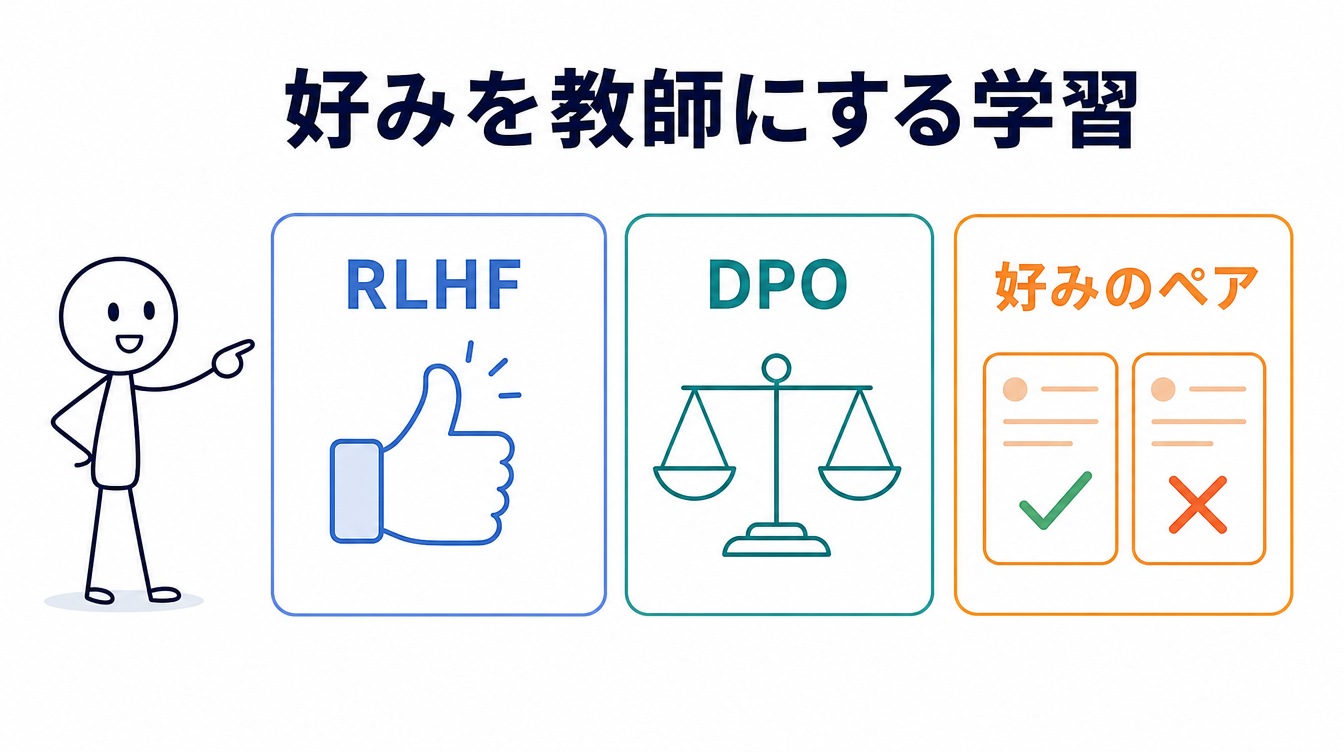
RLHFとDPOは、どちらも人間の好みを教師にする手法です。
RLHFの仕組み|報酬モデルと強化学習
RLHF(Reinforcement Learning from Human Feedback)には、単一の決定版論文はありません。
強化学習一般での原型は、2017年のChristianoらの論文です。
LLMへの適用例として最も広く参照されるのは、2022年のInstructGPT論文です。
Hugging FaceTRL公式の最新Taxonomyでは、GRPOTrainerやRLOOTrainerが主要なオンライン手法として案内されています。
PPOTrainerは、安定版v1.15.0のドキュメントの外、mainブランチにのみ存在します。
DPOの仕組み|報酬モデルを使わない選好最適化
DPO(Direct Preference Optimization)は、報酬モデルを別途学習しません。
DPOの論文は、単純な分類損失だけでRLHFと同じ問題を解けると提案しています。
報酬モデルの学習と強化学習という2段階を、1段階に圧縮した手法です。
論文の実験では、要約タスクの感情制御でPPOベースのRLHFを上回ったと報告されています。
SFTとDPOの違い|データの作り方がそもそも違う
悩んでる人SFTとDPO、結局どっちを使えばいいの?
情シス あおい教師にするデータの形が、そもそも違うんです。
SFTTrainerは、promptとcompletionのペア型データを使います。
DPOTrainerは、chosen(好ましい回答)とrejected(好ましくない回答)のペア型データを使います。
SFTは「正解」を1つ教え、DPOは「2つを比べた結果」を教えます。
この違いが、学習に必要なデータの作り方そのものを分けています。
ローカルで回すファインチューニング|4つの対応ツールを比較する
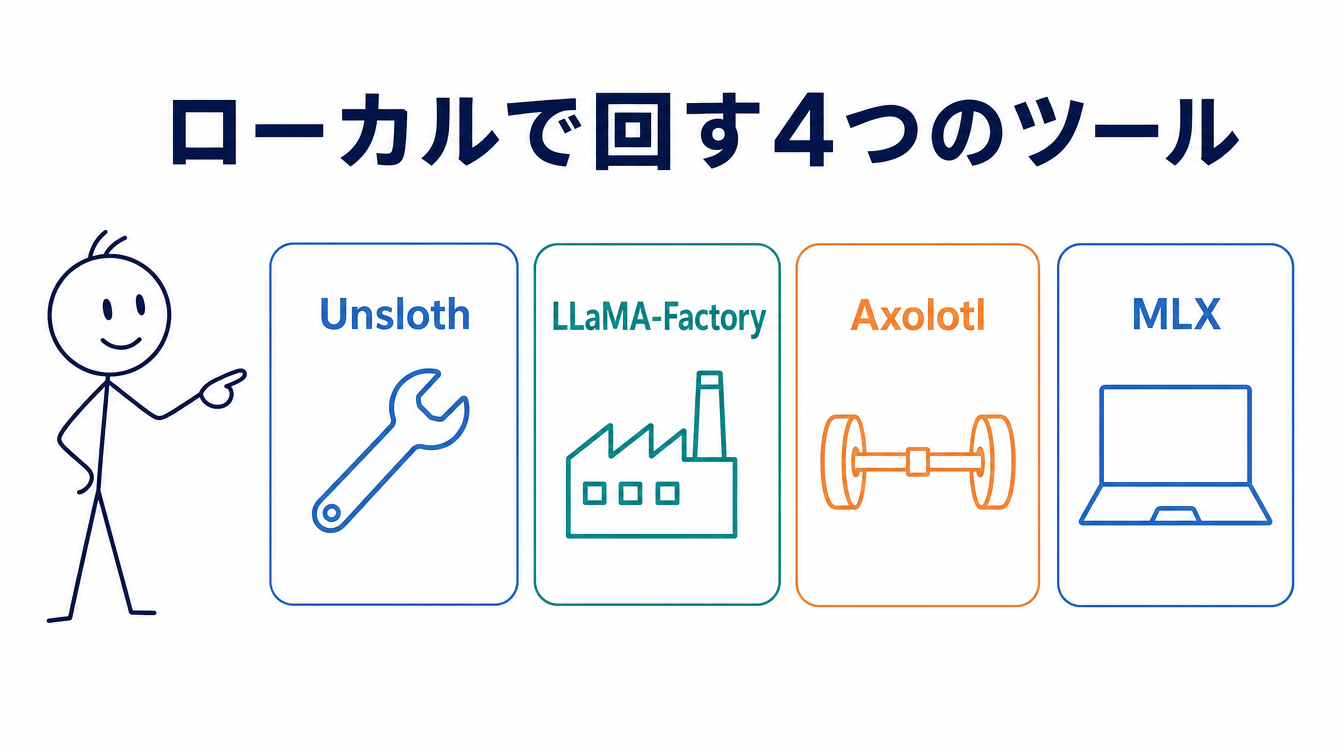
ローカルでファインチューニングを回す場合、ツールによって対応手法とライセンスが異なります。
Unsloth|ライブラリとDesktop UIの両方に対応
Unslothは、Apache License 2.0で配布されているOSSです。
2026年10月時点の最新バージョンは2026.10.3です(PyPI公式確認)。
公式READMEには、LoRA・QLoRA・フルファインチューニング・GRPO・DPOへの対応が明記されています。
LLaMA-FactoryとAxolotl|GUIで手法を切り替えられる
LLaMA-Factoryは、Apache License 2.0で配布されているOSSです。
2026年10月時点の最新バージョンは0.9.5で、16bitのフルFTから2〜8bitのQLoRAまで幅広く対応します。
Axolotlも同じApache License 2.0で、最新バージョンは0.20.0です。
公式READMEには、フルFT・LoRA・QLoRAに加え、DPO・KTO・ORPOといった選好チューニングへの対応も明記されています。
MLX|Apple Silicon環境のLoRA・QLoRA
MLX(mlx-lm)は、Appleが開発するMITライセンスのツールです。
2026年10月時点の最新バージョンは0.32.0です。
公式ドキュメントは、LoRAとQLoRAの両方に対応すると明記しています。
4つのツールの対応状況を一覧にしました。
| ツール | 開発元 | ライセンス | 最新バージョン(26年10月) | 対応手法 |
|---|---|---|---|---|
| Unsloth | Unsloth AI | Apache-2.0 | 2026.10.3 | LoRA/QLoRA/フルFT/GRPO/DPO |
| LLaMA-Factory | hiyouga | Apache-2.0 | 0.9.5 | フルFT/LoRA/QLoRA/DPO等 |
| Axolotl | Axolotl AI | Apache-2.0 | 0.20.0 | フルFT/LoRA/QLoRA/DPO等 |
| MLX LM | Apple | MIT | 0.32.0 | LoRA/QLoRA |
ライセンス・バージョンは2026年10月時点の確認値です。導入前に公式リリースで最新状況を確認してください。
ファインチューニングの種類|結局どれを選ぶべきか
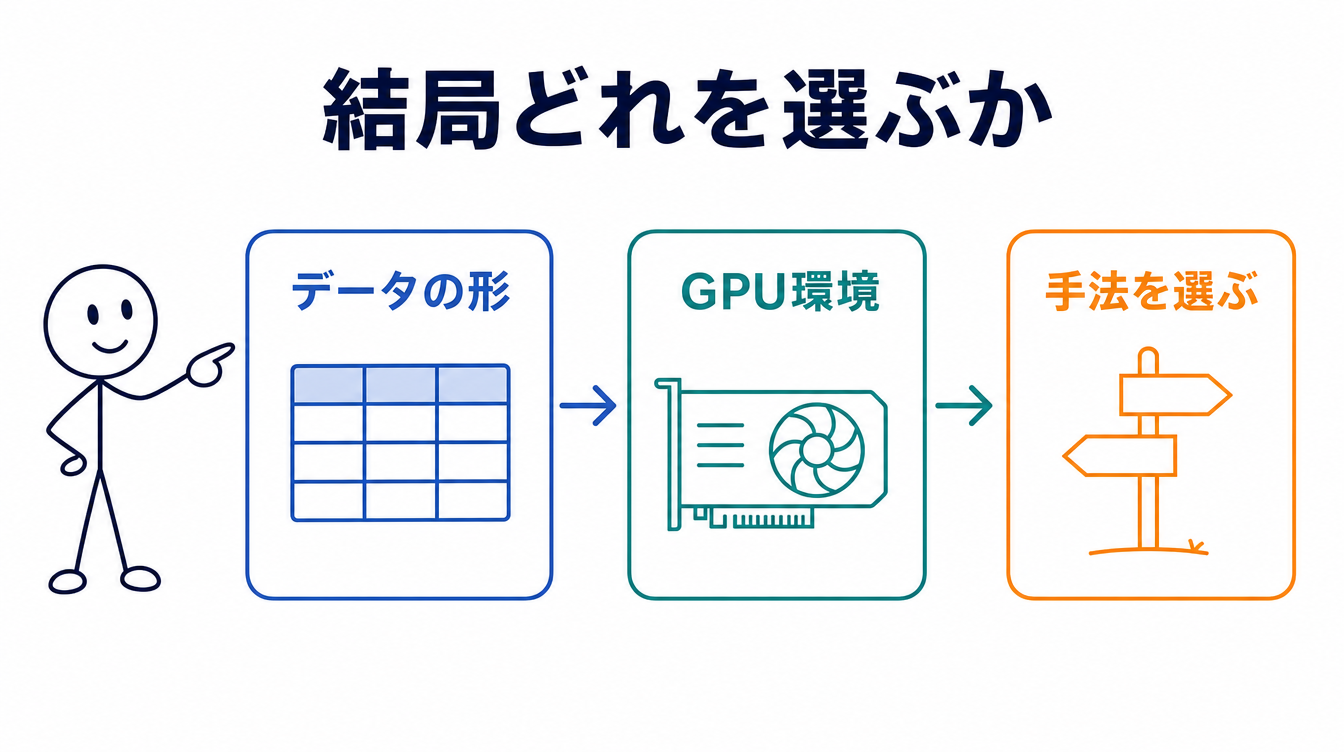
手法選びは、持っているデータの形と、使えるGPU環境で大きく絞れます。
判断フロー|データの形とGPU環境で絞る
以下の順に確認すると、候補を自然に絞り込めます。
- 正解例(prompt-completion)しかない:SFTが候補になります
- 2つの回答を比較した好みのデータがある:DPOが候補になります
- GPUが48GB未満で大きいモデルを動かしたい:QLoRAが候補になります
- GPUに余裕があり学習の自由度を優先したい:フルFTやLoRAが候補になります
- 報酬モデルを別途作り込みたい:RLHFが候補になります
そもそもどのベースモデルを選ぶか迷っている場合は、ローカルLLMおすすめモデル比較から検討してみてください。
データの形が決まれば、手法はおおよそ1つか2つに絞れます。
RAGや知識蒸留との違いが気になる場合
ファインチューニング以外にも、モデルの出力を変える方法があります。
RAG(検索で外部知識を足す方法)や、知識蒸留(大きいモデルの出力を小さいモデルに学ばせる方法)が代表例です。
そもそもファインチューニングで良いのか迷う場合は、アプローチ自体を比較して考える必要があります。
ファインチューニングに関するよくある質問
ファインチューニングに関するよくある質問をまとめました。
- SFTとDPOはどちらを先に試すべきですか?
-
正解例を用意できるならSFT、好みのペアデータがあるならDPOが向いています。
データの形で決めるのが近道です。
- RLHFは必ずPPOを使いますか?
-
使いません。TRL公式の最新Taxonomyでは、GRPOTrainerやRLOOTrainerが主要なオンライン手法として案内されています。
- LoRAとQLoRAはどちらが省メモリですか?
-
QLoRAの方が省メモリです。4bit量子化と組み合わせることで、65Bモデルを単一の48GB GPUで学習できたと論文は報告しています。
- フルファインチューニングに必要なVRAMはどれくらいですか?
-
公式に数値の目安は示されていません。
LoRA・QLoRAの数値は相対比較や特定条件つきの報告であり、フルFT単体の目安は確認できていません。
- ローカルで回すツールはどれを選べばいいですか?
-
OS・GPU・対応手法で変わります。Apple SiliconならMLXが候補です。
NVIDIA系で手法を広く試したいなら、Unsloth・LLaMA-Factory・Axolotlが候補です。
まとめ|ファインチューニングの種類と選び方を理解する
ファインチューニングの種類と選び方について、ここまでの内容を整理します。
2つの軸:フルFT・SFT・LoRA・QLoRA・RLHF・DPOは、「何を更新するか」と「何を教師にするか」で分類できます。
SFTとDPOの違い:正解例を教師にするか、好みのペアを教師にするかという、データの作り方そのものの違いです。
LoRA・QLoRAの数値:フルFTとの相対比較や特定条件つきの報告であり、絶対値としては独立していません。
ローカルで回すなら:Unsloth・LLaMA-Factory・Axolotl・MLXのライセンスとバージョンを確認してから選びます。
判断材料:持っているデータの形と、使えるGPU環境が決め手になります。
公式情報は更新が速いため、導入前には必ず公式リリースで最新状況を確認してください。
手法選びやモデル選定で迷ったら、以下もあわせて確認してみてください。
- VRAM別に動かせるモデル一覧:搭載VRAMから動かせるモデルクラスを判断できます
- ローカルLLM用GPUおすすめ:学習・推論に使うGPU自体を選ぶときに使えます
- ローカルLLMおすすめモデル比較:ファインチューニングするベースモデルを選ぶときに使えます
- ローカルLLMの活用方法(カテゴリトップ):他の活用例もまとめて確認できます
参考資料
LoRA論文(arXiv)
QLoRA論文(arXiv)
DPO論文(arXiv)
RLHF原典・Christiano et al. 2017(arXiv)
InstructGPT論文(arXiv)
Hugging Face PEFT公式ドキュメント
Hugging Face TRL公式ドキュメント

コメント