 悩んでる人
RAGとファインチューニング、結局どっちを使えばいいの?
 情シス あおい
実は、2択ではありません。知識蒸留という第3の選択肢もあります。
ローカルLLMで何かを改善したいとき、多くの人がこの2つの技術の間で迷います。
どちらも生成AIの出力を良くする技術ですが、解決する課題はまったく別です。
とはいえ、2つの技術だけで比較すると、選択肢を狭めてしまうことがあります。
そこで、知識蒸留を含めた3つの技術を、解く課題から整理しました。
今回は、RAG・ファインチューニング・知識蒸留という3つの技術の違いと使い分けを紹介します。
- RAG・ファインチューニング・知識蒸留が、それぞれ解決する課題の違い
- 比較表でわかる、必要なもの・更新のしやすさ・組み合わせ可否
- 自分の状況から、どの技術を検討すべきかの判断基準
先に比較表だけ見たい方は比較表からどうぞ。
※本記事の数値・条件は、論文や公式ドキュメントの記載にもとづいています(2026年10月確認)。
RAGとファインチューニングの違い|知識蒸留を加えると3つの技術になる
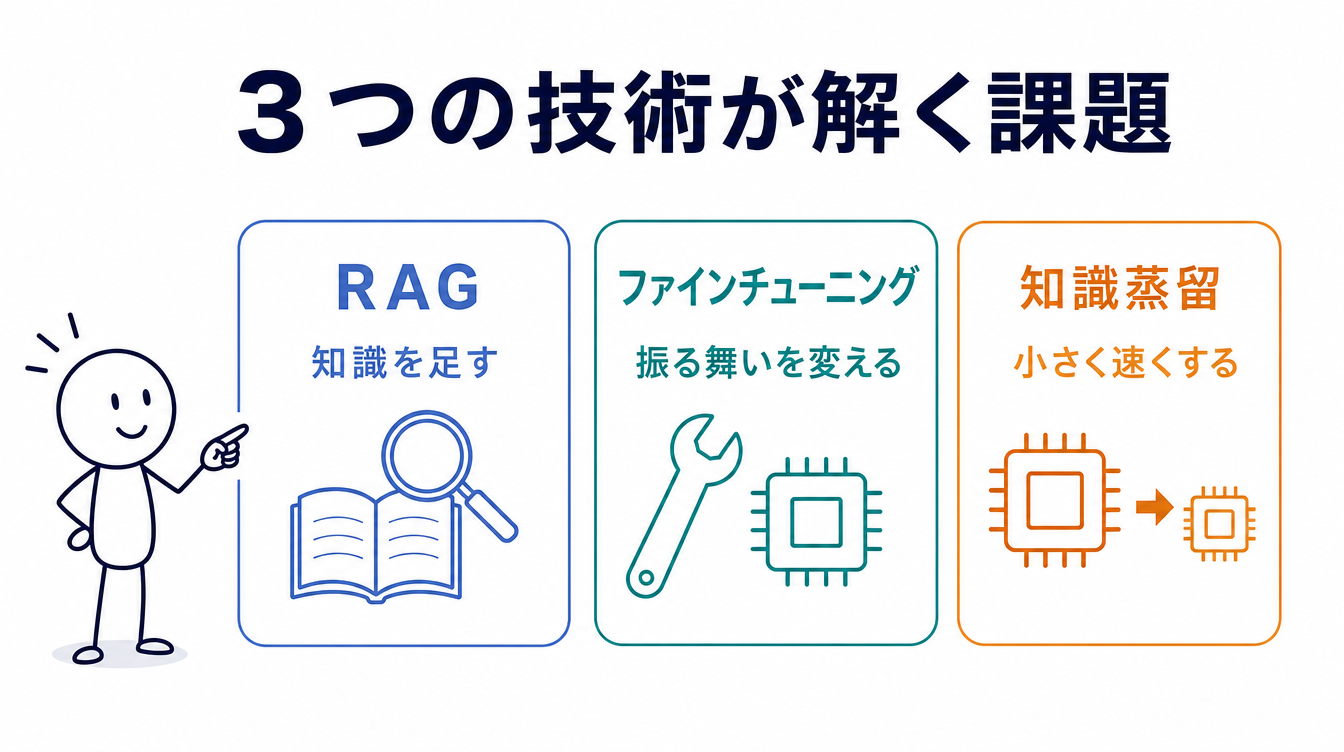
RAG・ファインチューニング・知識蒸留は、それぞれ違う課題を解決します。
3つの技術が解く課題
RAGは、モデルに外部の知識を検索して足す技術です。
ファインチューニングは、モデル自体の振る舞いを変えます。
知識蒸留は、大きなモデルの性能を、小さなモデルに移す技術です。
多くの比較記事はRAGとファインチューニングの2つだけを扱い、知識蒸留には触れていません。
この記事では、知識蒸留を含めた3つの技術を同じ重みで比較します。
RAGとファインチューニングの関係
RAGとファインチューニングは、どちらか一方を選ぶ技術ではありません。
RAGの原論文(Lewis et al., 2020)は、検索を組み込んだモデルをファインチューニングする手法を提案しています。
つまり、最初から組み合わせて使うことを想定した技術と言えます。
ファインチューニングしたモデルにRAGを組み合わせる構成も選べます。
RAGとは|モデルに外部知識を検索して足す技術
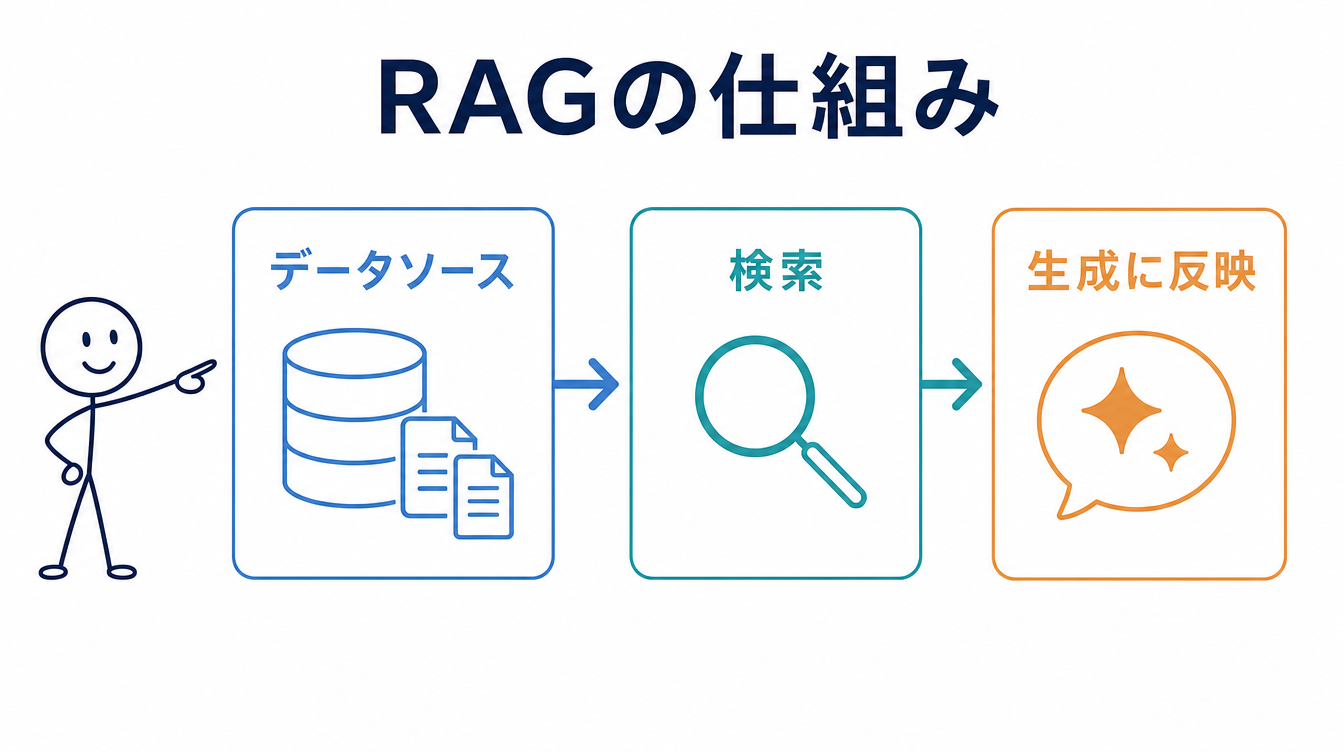
RAGは、モデル自体を変えずに、外部データから必要な情報を検索して答えに加える技術です。
RAGの仕組み
AWS公式による定義は、「データソースの情報で応答の関連性と精度を高める技術」です。
検索対象のデータを更新すれば、モデル自体を再学習せずに最新の情報を反映できます。
原論文(Lewis et al., 2020)では、事前学習済みモデルと検索システムを組み合わせる手法として提案されました。
検索対象のデータ整備が前提になる技術です。
ファインチューニングとは|学習済みモデルの振る舞いを変える技術
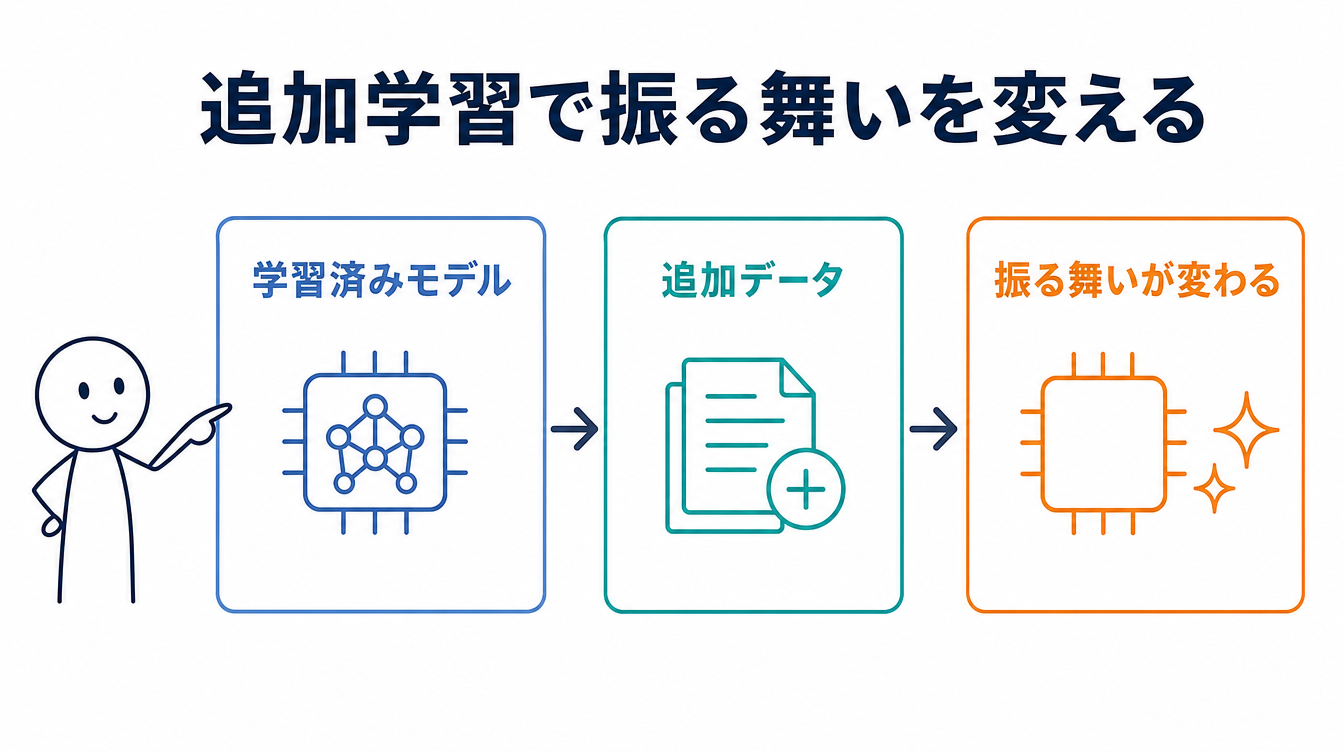
ファインチューニングは、学習済みモデルに追加学習させて、応答の振る舞いそのものを変える技術です。
ファインチューニングの仕組み
Hugging Face公式は、特定のタスクやドメイン向けの小さいデータセットで学習を継続する処理と定義しています。
事前学習との違いは、ランダムな重みから始めない点だけです。
そのため、データ・計算量・時間を事前学習より大幅に減らせます。
クラウドFTとローカルFTの違い|OpenAIは新規受付を段階的に終了
OpenAIは、自社クラウド上のファインチューニング基盤の新規提供を段階的に終了しています。
- 2026年5月7日:これまでFTを実行していない組織は新規実行が不可
- 2026年7月2日:過去60日間に推論していない組織は新規ジョブ作成が不可
- 2027年1月6日:既存アクティブ顧客も新規ジョブ作成が不可になる
出典はOpenAI公式の廃止スケジュールです(2026年10月確認)。
この終了は、OpenAIのクラウドAPI上のFTに限った話です。
Hugging FaceやUnslothを使った、ローカル・OSSモデルのファインチューニングには影響しません。
手元のGPUでモデルを育てたい場合は、クラウド側の動向を気にする必要はありません。
そもそもローカルLLMでどこまでできるかは、ローカルLLMでできることでも整理しています。
知識蒸留とは|モデルを小さく・速くする第3の技術
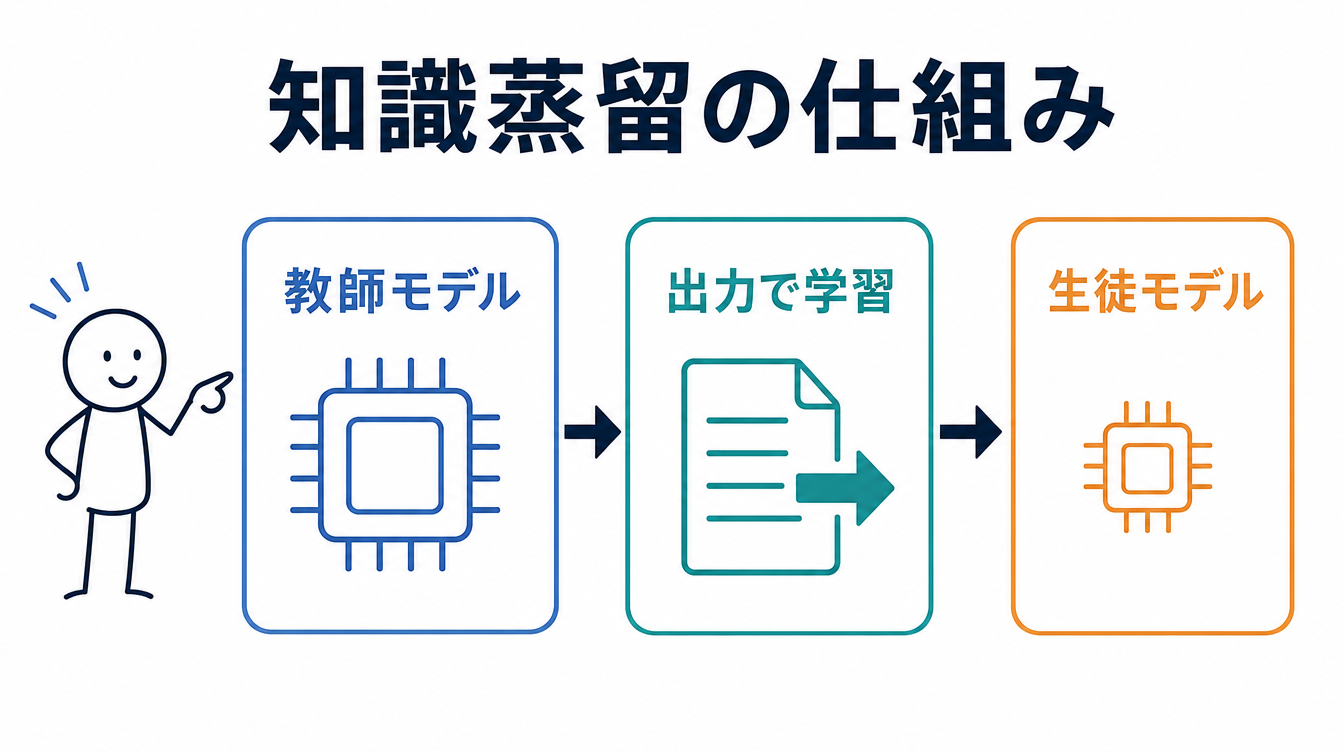
知識蒸留は、大きなモデルが持つ性能を、小さなモデルに移して再現する技術です。
小さく速くできる条件付きの実例|DistilBERT
蒸留の考え方は、Hinton氏らの原論文(2015年)で提案されました。
言語モデルでの代表例が、DistilBERTです。
BERTのサイズを40%削減しながら、言語理解能力の97%を維持し、60%高速化できると報告されています。
これはDistilBERT論文の要旨にある数値で、条件付きの実測例です。
蒸留後のモデルが、常に同じ比率で縮むとは限りません。
教師モデルの利用規約を確認する|事業者で対応が正反対
悩んでる人蒸留って、教師モデルの出力を勝手に使っていいの?
情シス あおい規約次第です。事業者によって、許可と禁止がはっきり分かれています。
知識蒸留では、教師モデルの出力を使って生徒モデルを学習させます。
そのため、教師モデルの利用規約で、蒸留が許可されているかの確認が必要です。
一方、DeepSeekの利用規約は、「モデル蒸留を含む用途」を明示的に許可しています。
規約は事業者によって正反対です。利用前に最新の規約を確認してください(2026年10月時点)。
この確認は法的な可否を判断するものではなく、条文の記載を事実として比較するものです。
ローカルで試す現実的な手段|Hugging Face TRLのGKDTrainer
クラウド側では、AWS Bedrock Model Distillationが蒸留を完全マネージドで提供しています。
最大500%高速化・最大75%低コスト・精度低下2%未満という数値を公式サイトに掲載しています(RAGのような用途で)。
ただし、この数値はAWSの公式マーケティングページの記載であり、査読論文の実測値ではありません。
ローカルで再現できる公式ツールとしては、Hugging Face TRLのGKDTrainerが確認できます。
教師モデルを指定して生徒モデルを学習させる仕組みです。
配布されている蒸留モデルの例として、DeepSeek-R1-Distill-Qwen-32Bがあります。
ライセンスタグはMITですが、ベースはApache 2.0のQwen2.5派生です(2026年10月確認)。
同シリーズのDeepSeek-R1-Distill-Llama-70Bは、Llama 3.3ライセンスの条件を引き継ぎます。
同じシリーズ名でも、ベースモデルによってライセンスの条件が変わります。
RAG・ファインチューニング・知識蒸留の比較表|必要なもの・更新しやすさ・組み合わせ可否
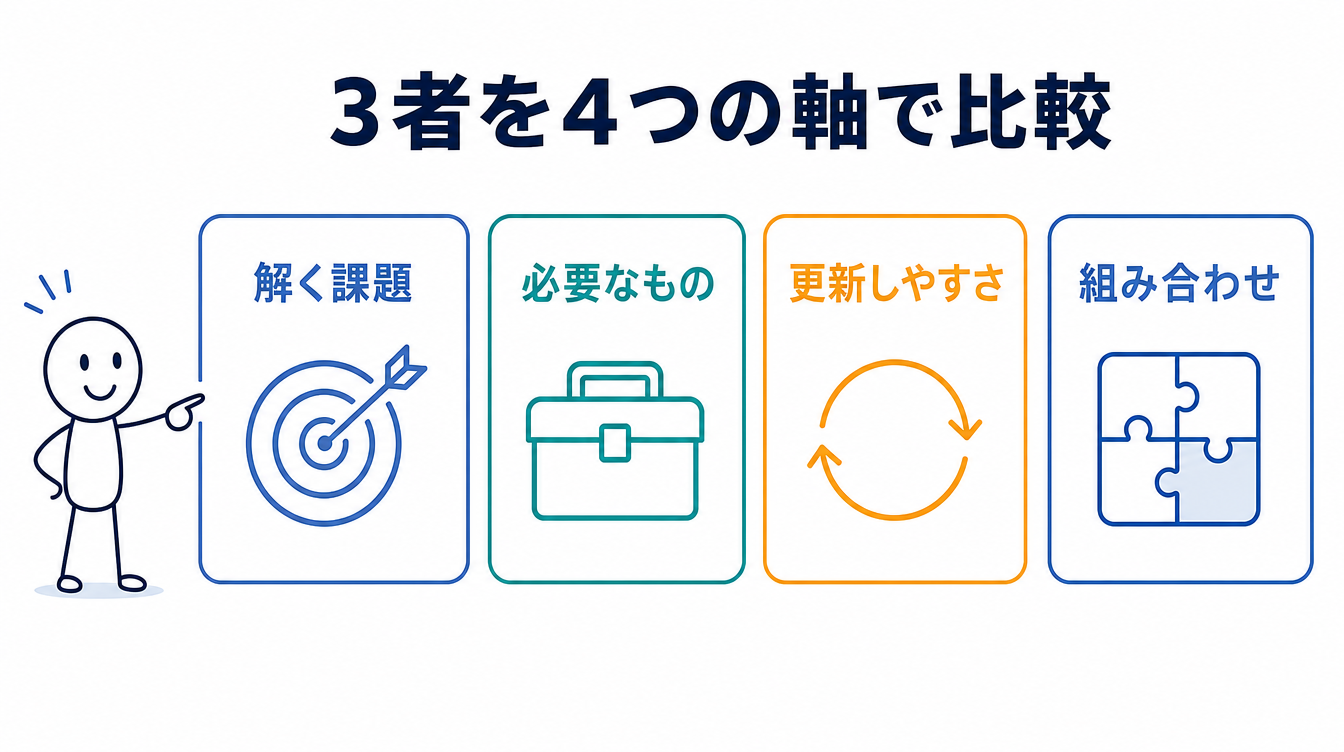
3つの技術を、解く課題・必要なもの・更新のしやすさ・組み合わせ可否で比較しました。
| 軸 | RAG | ファインチューニング | 知識蒸留 |
|---|---|---|---|
| 解く課題 | 知識を足す | 振る舞いを変える | 小さく速くする |
| 必要なもの | 検索基盤・データ整備 | ラベル付きデータ・GPU | 教師モデルの出力・学習基盤 |
| 更新のしやすさ | データ更新だけで反映 | 再学習が必要 | 教師が変われば再蒸留 |
| 組み合わせ可否 | ◯ | ◯ | ◯ |
| 説明のしやすさ | 高い(根拠文書を提示できる) | 低い(内部化され示しにくい) | FTと同様に低い |
組み合わせ可否は、どの技術も◯です。排他的に選ぶ技術ではありません。
更新のしやすさで見ると、情報の鮮度が重要ならRAGが有利です。
説明のしやすさが問われる場面では、根拠を提示できるRAGの方が向いています。
使い分けの基準|RAGとファインチューニング、蒸留をどう選ぶか
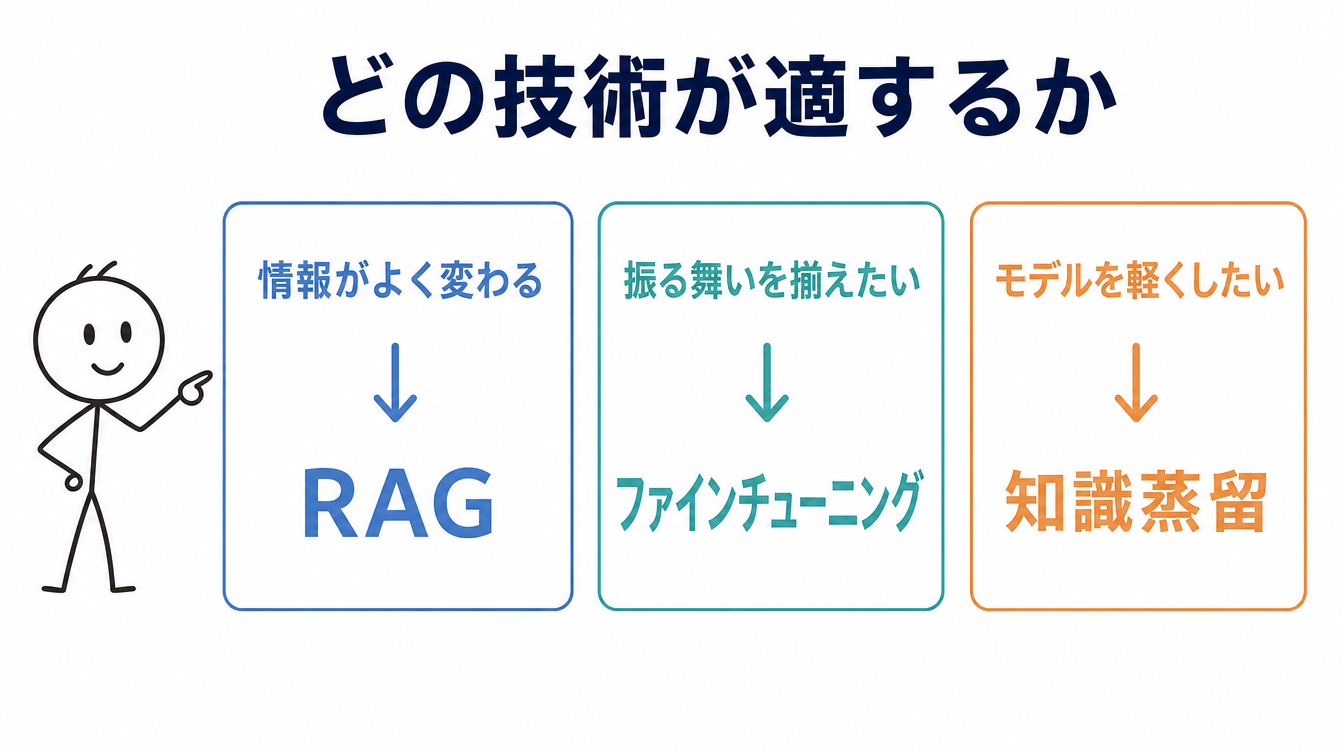
自分の課題がどれに当てはまるかを見れば、検討する技術を絞り込めます。
RAGが適する場面
悩んでる人社内文書を検索させたいだけなのに、ファインチューニングは要る?
情シス あおい多くの場合、不要です。情報を足すだけならRAGで十分です。
頻繁に更新される情報を扱うなら、RAGが向いています。
検索元の文書を提示できるため、判断の根拠も示しやすくなります。
個人開発での実例は、ローカルLLMの活用事例のとおりです。
ファインチューニングが適する場面
出力の振る舞いそのものを一貫させたいなら、ファインチューニングが向いています。口調や出力形式を揃えたい場合がその例です。
Google Cloud公式ドキュメントは、プロンプト設計だけでは対応しきれない複雑で独自なタスクに効果的だと説明しています。
同ドキュメントが挙げる目安は、ラベル付きデータ100件程度以上です(26年10月確認)。
ただし、判断の根拠はモデル内部に埋め込まれるため、RAGほど説明しやすくはありません。
知識蒸留が適する場面
すでに動いている大きなモデルを小さく速くしたい場合は、知識蒸留を検討します。
ローカルで試す場合は、教師モデルの規約確認が前提です。
確認できれば、GKDTrainerのような公式ツールが使えます。
振る舞い自体を変えたいわけではないなら、蒸留はファインチューニングの代わりにはなりません。
RAG・ファインチューニング・知識蒸留に関するよくある質問
RAG・ファインチューニング・知識蒸留に関するよくある質問をまとめました。
- RAGとファインチューニングは同時に使えますか?
-
はい。RAGの原論文自体が、検索を組み込んだモデルをファインチューニングする手法を提案しています。
ファインチューニングしたモデルにRAGを組み合わせる構成も選べます。
- 知識蒸留は個人でも試せますか?
-
公式に現存するツールとして、Hugging Face TRLのGKDTrainerが確認できます。
教師モデルを指定して生徒モデルを学習させる仕組みです。
- ファインチューニングはOpenAIでもできますか?
-
OpenAIは、自社クラウド上のFT新規提供を段階的に終了しています。
2027年1月には既存顧客も新規ジョブが不可になりますが、ローカル・OSSモデルには影響しません。
- 蒸留したモデルは元のモデルと同じライセンスになりますか?
-
いいえ。配布元が付けたライセンスタグと、生徒モデルのベースモデルのライセンス、両方の確認が必要です。
DeepSeek-R1-Distillシリーズも、ベースがQwenかLlamaかでライセンスの条件が変わります。
- RAGを使えば精度は必ず上がりますか?
-
上がりません。検索の質が悪ければ、RAGを入れても精度は改善しません。
検索対象のデータ整備が前提になる技術です。
まとめ|RAGとファインチューニングの違いと、知識蒸留を含めた結論
RAGとファインチューニングの違いに、知識蒸留を加えて整理した内容をまとめます。
RAG:モデルを変えずに、外部知識を検索して足す技術です。
ファインチューニング:学習済みモデルの振る舞いそのものを変えます。
知識蒸留:大きなモデルの性能を、小さなモデルに移す技術です。
組み合わせ:3つとも排他的ではなく、組み合わせて使える技術です。
確認事項:蒸留は教師モデルの利用規約を、事業者ごとに確認してください。
どちらを選ぶかより、何を解決したいかから考えるのが、判断を間違えないコツです。
接続方法や構成で迷ったら、以下もあわせて確認してみてください。
- ローカルLLMでできること:RAG・ファインチューニングを含めた全体像を整理しています
- ローカルLLMの活用事例:個人・小規模チームでの実例を紹介しています
- ローカルLLMの活用方法(カテゴリトップ):他の活用例もまとめて確認できます
参考資料
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks | arXiv
Distilling the Knowledge in a Neural Network | arXiv
DistilBERT | arXiv
Fine-tuning | Hugging Face
GKD Trainer | Hugging Face TRL
Model Distillation | AWS Bedrock
Gemini API Additional Terms of Service | Google AI
Terms of Service | DeepSeek Open Platform

コメント