 悩んでる人
Hermes Agentって、結局ローカルLLMでも動くの?
 情シス あおい
動きます。ただしコンテキスト長の設定を間違えると、起動の時点で止まります。
Hermes Agentは、Nous Researchが公開する自律型AIエージェントのソフトです。
無料で試せるため、API料金を気にせずエージェントの挙動を確認できます。
とはいえ、接続手順を一つ間違えるだけで、起動画面にすら進めないことがあります。
そこで、公式ドキュメントに基づく接続条件と注意点を、バックエンド別に整理しました。
今回は、Hermes AgentをローカルLLMに接続する手順と判断材料を紹介します。
- Hermes AgentとNous Hermesモデルは別物で、公式サイトも1つだけということ
- Ollama・LM Studio・vLLMなど、バックエンドごとに必要な接続設定
- 「RAG対応」ではなく、スキルとメモリで学習するという正確な仕組み
先に接続手順だけ知りたい方はローカルLLMとの接続方法からどうぞ。
※本記事の手順は、Hermes Agent公式ドキュメントの記載にもとづいています(2026年10月確認)。
Hermes Agentとは|自律型AIエージェントとNous Hermesモデルの違い
Hermes Agentは、学習ループを内蔵した自律型のAIエージェントです。会話を重ねるほど、エージェント自身がスキルを増やしていく設計になっています。
できること|マルチプラットフォーム常駐と学習ループ
公式は、IDE常駐のコーディング支援でもチャットボットでもないと説明しています。
- マルチプラットフォーム常駐:Telegram・Discord・Slack・WhatsApp・Signal・Email・CLIを1つのゲートウェイから操作できます
- 学習ループ:複雑なタスクの後に自分でスキルを作り、使うたびに改善します
- スケジュール実行:内蔵cronで日次レポートや夜間バックアップを無人実行できます
- 実行環境7種:ローカル・Docker・SSHなど7種類から選べます
DaytonaやModalはサーバーレスのため、待機中のコストがほぼかかりません。
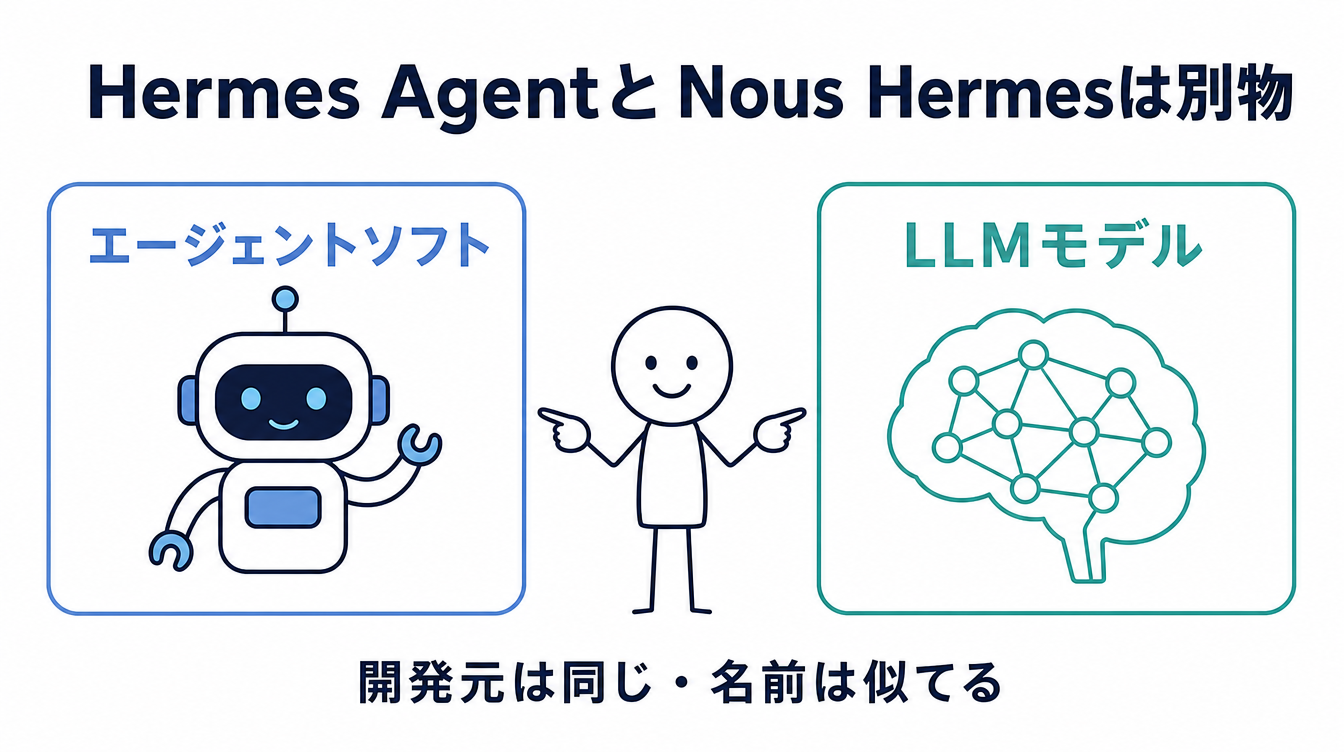
Nous Hermes(モデル)とHermes Agent(エージェントソフト)は別物
悩んでる人Hermesって名前、どこかで見た気がするけど同じもの?
情シス あおい別物です。開発元が同じNous Researchというだけで、製品としては分かれています。
Nous Hermesは、Hermes 2・3・4などのLLMモデルファミリーの名称です。
Hermes Agentは、そのモデルを含めた好きなモデルを動かす側の、エージェントソフトです。
Hermes AgentでNous Hermesモデルを動かすことはできますが、名前が同じだけの別製品という関係になります。
公式サイトは1つだけ|検索結果に出る非公式サイトへの注意
公式サイトはhermes-agent.nousresearch.comのみです。
公式リポジトリはGitHubのNousResearch/hermes-agentです。
インストールスクリプトの実行や有料プランへの登録は、上記2つの公式以外では行わないでください。
対応OS・必要環境|Windows・macOS・Linuxでの違い
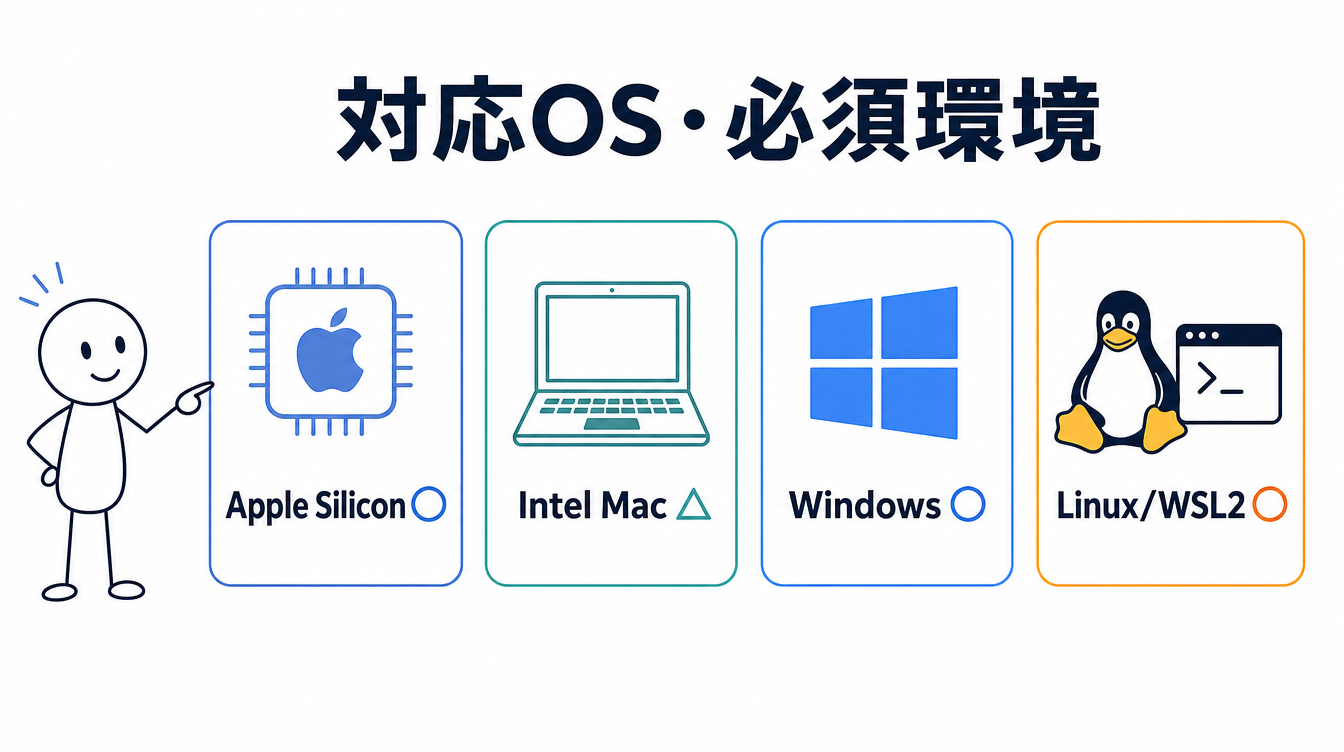
Hermes Agentは、Windows・macOS・Linuxすべてで動きます。ただしMacだけは、搭載チップの種類によって対応のレベルが変わります。
Apple SiliconとIntel Macの違い
Apple Silicon搭載Macは、公式インストーラ(Hermes-Setup.dmg)を含めて正式対応です。
ただし、CLI経由のインストールとhermes desktopの起動自体は可能です。
制限があるのは、ブートストラップ用インストーラ(Hermes-Setup.dmg)だけという整理です。
手元のMacがどちらのチップか、先に確認しておく必要があります。
ネイティブWindows対応とWSL2の使い分け
Windows 10・11(x86_64・aarch64)は、WSL2なしのネイティブ対応です。
MSIXパッケージを使う場合は、Windows 11の22H2以降が条件になります。
PowerShellからの1行インストールコマンドが、公式に用意されています。
iex (irm https://hermes-agent.nousresearch.com/install.ps1)WSL2上でモデルサーバーに繋ぐ場合は、Windows側のlocalhostに直接届かないことがあります。
Windows 11 22H2以降なら、.wslconfigをmirroredモードに設定すると解決できます。
ローカルLLMとの接続方法|Ollama・LM Studio・vLLMでHermes Agentを使う
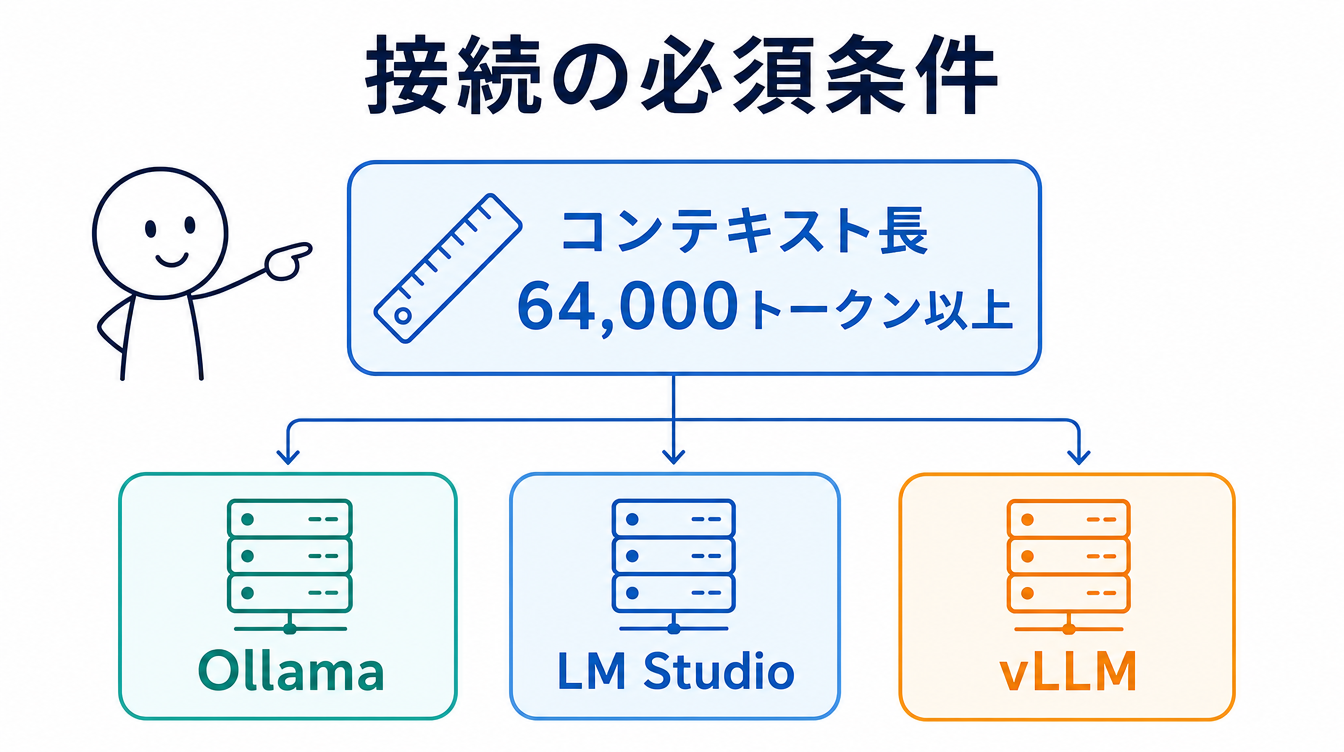
Hermes Agentは、OpenAI互換のAPIを話すサーバーなら、どれでも接続できます。ただし、コンテキスト長だけはどのバックエンドでも譲れない条件です。
共通の必須条件|コンテキスト長64,000トークン以上
Hermes Agentは、起動時に64,000トークン未満のコンテキスト長を拒否します。
パラメータ数より、コンテキスト長が足りているかの方が実質的な要件です。
公式はVRAMの目安を一切示していません。基準になるのは、あくまでコンテキスト長です。
Ollamaで接続する|コンテキスト長のハマりどころ
ollama pull qwen2.5-coder:32b
ollama serveOllamaは、hermes modelから「Custom endpoint」を選ぶだけで接続できます。
URLにはhttp://localhost:11434/v1を入力し、APIキーは空のままで構いません。
悩んでる人せっかく繋いだのに、起動画面が出てこない…
情シス あおいOllamaのデフォルトのコンテキスト長が、そもそも足りていないかもしれません。
| 搭載VRAM | Ollamaのデフォルトコンテキスト長 |
|---|---|
| 24GB未満 | 4,096トークン |
| 24〜48GB | 32,768トークン |
| 48GB以上 | 256,000トークン |
24GB未満の環境では、デフォルトのままだと64,000トークンに届きません。
OpenAI互換API経由では、コンテキスト長を直接指定できない点にも注意してください。
- 環境変数
OLLAMA_CONTEXT_LENGTH=64000を指定してollama serveを起動する(最も手早い方法) - systemd管理の場合は
systemctl edit ollama.serviceに環境変数を追記して再起動する - Modelfileに
PARAMETER num_ctx 64000を書いてモデル単位で永続化する
設定後は、ollama psのCONTEXT列で反映されているか確認できます。
Windowsから接続してもサーバーに届かない場合は、WSL2のネットワーク設定も確認してください。
LM Studioで接続する|公式統合ガイドの手順
lms server start
lms load qwen2.5-coder --context-length 64000
LM Studioは、公式が「ファーストクラスのプロバイダ」と明記する統合先です。
LM Studio公式の統合ガイドも、同じ内容を案内しています(2026年10月確認)。
hermes modelで「LM Studio」を選べば、動いているサーバーが自動で見つかります。
ツール呼び出しの対応は、LM Studio 0.3.6以降が条件です。
Just-In-Timeロードに切り替えると、必要な時だけモデルを読み込ませる運用もできます。
LM Studio自体には、「Chat with Documents」という文書検索機能が別途あります。
これはLM Studio単体の機能で、Hermes Agent側の機能ではありません。混同しないでください。
vLLM・llama.cppで接続する|ツール呼び出しフラグが必須
vllm serve meta-llama/Llama-3.1-70B-Instruct --port 8000 --max-model-len 65536 --enable-auto-tool-choice --tool-call-parser hermesvLLMは、--enable-auto-tool-choiceと--tool-call-parser hermesの指定が必須です。
付けないと、ツール呼び出しが生のJSONテキストとして出力され、機能しません。
./build/bin/llama-server --jinja -fa -c 64000 -ngl 99 -m models/qwen2.5-coder-32b-instruct-Q4_K_M.gguf --port 8080llama.cppも同様に、--jinjaフラグがないとtoolsパラメータ自体が無視されます。
並列スロット(-np)を使う場合は、合計コンテキストがスロット数で割られる点に注意してください。
SGLangという選択肢もありますが、デフォルトの最大出力トークンが128と小さめです。
応答が途切れる場合は、サーバー側で出力上限を調整する必要があります。
推奨モデルとVRAMの目安|Ollama公式の実例から
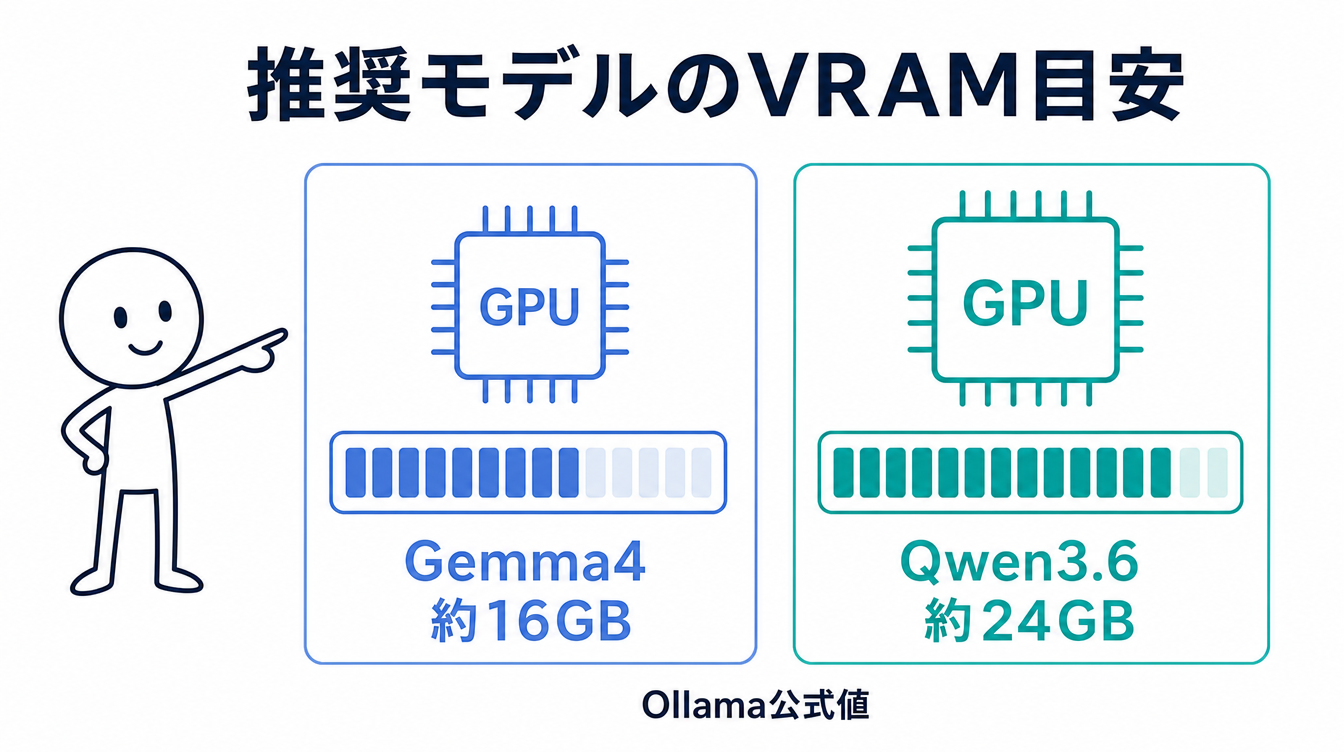
Hermes Agent自身は、VRAMの基準を示していません。数字で示しているのは、統合先であるOllama公式のドキュメントです。
ワンコマンド導入「ollama launch hermes」
Ollamaには、Hermes Agentの導入からモデル選択・接続までを1コマンドで終える機能があります。
ollama launch hermes
ollama launch hermes-desktop
Hermesが未導入なら案内し、モデル選択から接続設定まで自動で進めてくれます。
手動セットアップ(hermes modelで選ぶ方法)との違いは、設定ファイルを自分で書くかどうかです。
Gemma 4・Qwen3.6のVRAM目安(Ollama公式値)
| 区分 | モデル | 用途 | VRAM目安 |
|---|---|---|---|
| ローカル | Gemma 4世代 | 推論・コード生成 | 約16GB |
| ローカル | Qwen3.6(Qwen3以降世代) | 推論・コーディング・視覚理解 | 約24GB |
| クラウド | kimi-k2.5:cloud 等4種 | 推論・マルチモーダル | ー(クラウド実行) |
この数値はOllama公式の統合ガイドに記載されたもので、Hermes Agent公式の基準ではありません。
Gemma 4世代は2026年7月時点でApache 2.0に変更されており、商用利用が可能です。
Qwen3以降の世代も、全面Apache 2.0です(いずれも世代ベースでの確認。2026年10月確認)。
搭載VRAM別にどこまでのモデルが動くかは、VRAM別に動かせるモデル一覧で詳しく確認できます。
MCP連携とメモリ・スキル機能|Hermes Agentは「RAG」ではない
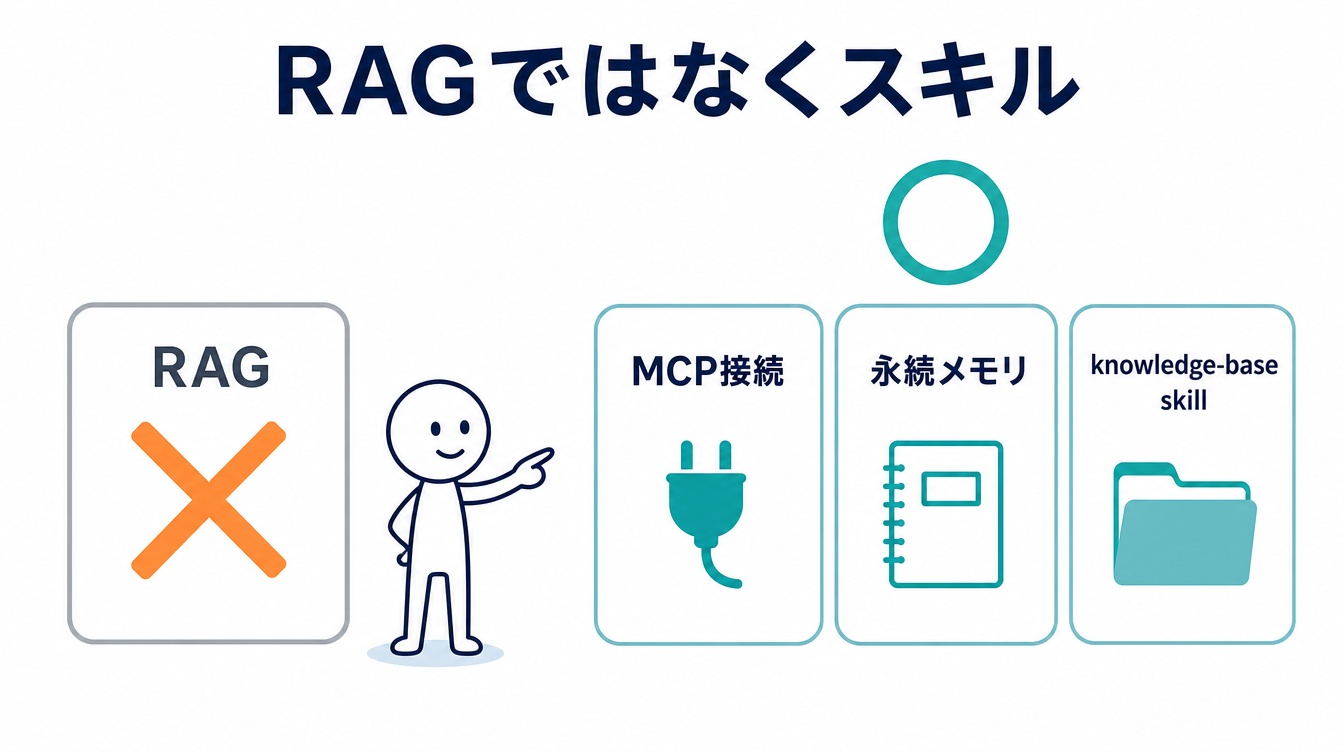
Hermes Agentには、外部データに繋ぐ仕組みがあります。ただし、それは一般的なベクトル検索型のRAGとは別の実装です。
MCPで外部ツールに接続する
MCP(Model Context Protocol)は、標準インストールに含まれています。
追加のインストールなしで、GitHubやデータベースなど外部のツールサーバーに接続できます。
mcp_servers:
  filesystem:
    command: "npx"
    args: ["-y", "@modelcontextprotocol/server-filesystem", "/home/user/projects"]
Nous社内で審査済みのMCPサーバーカタログがあり、デフォルトはすべて無効になっています。
Claude Codeの設定ファイルからの移行コマンドも、公式に用意されています。
永続メモリとスキル(knowledge-base skill)の仕組み
永続メモリは、MEMORY.mdとUSER.mdという2つのファイルで管理されます。
上限は合わせて約1,300トークン相当で、超える書き込みはエラーになります。
自動要約はされず、エージェント自身が内容を整理し直す設計です。
/learnコマンドで渡した文書は、索引付きの「スキル」として保存されます。
必要な部分だけをオンデマンドで読み込む仕組みで、ベクトル検索に基づく一般的なRAGとは実装が異なります。
公式ドキュメントにも、Hermes Agent自身の機能として「RAG」という語は使われていません。
「RAG対応」ではなく、スキルによる学習型のナレッジ管理というのが正確な理解です。
自律エージェントの安全機構|Hermes Agentの8層セキュリティモデル
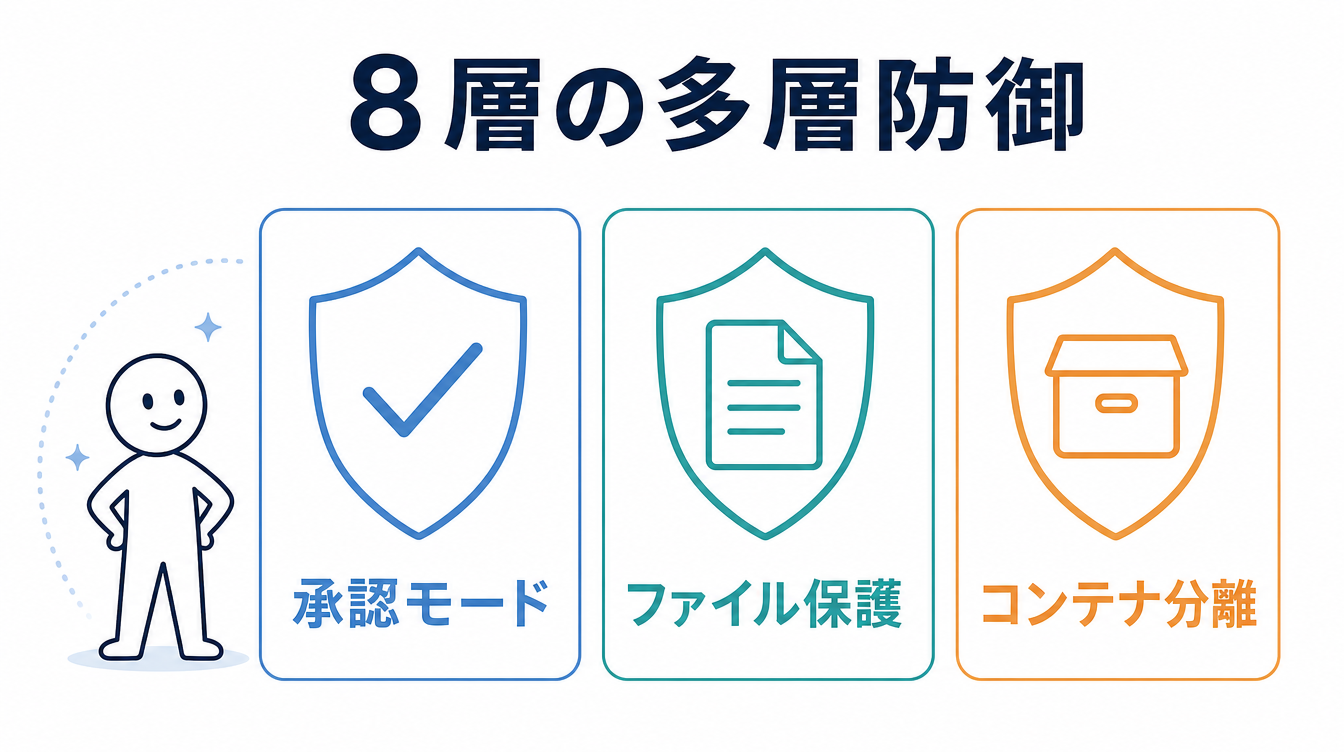
Hermes Agentは、多層防御という考え方で複数の安全境界を設けています。
- ユーザー認可(誰がエージェントと話せるか)
- 危険コマンドの承認(Human-in-the-loop)
- ファイル書き込みの拒否リスト
- コンテナ分離(Docker・Singularity・Modal)
- MCP認証情報のフィルタリング
- コンテキストファイルのスキャン(プロンプトインジェクション検知)
- セッション間の分離
- 入力のサニタイズ(シェルインジェクション対策)
承認モードは3段階|smart・manual・off
危険なコマンドの扱いは、approvals.modeで3段階から選べます。
| モード | 挙動 |
|---|---|
| smart(既定) | 補助LLMがリスクを評価し、不確実なものは人間に確認 |
| manual | 危険コマンドは常に人間の承認を要求 |
| off | 全チェック無効化(--yolo相当) |
どの段階から始めるかは、許可する操作の範囲を少しずつ広げていく発想と重なります。
ファイル書き込み保護とコンテナ分離
~/.ssh/や~/.aws/など、認証情報が入る場所は常時書き込み拒否です。
プロジェクト内の.env系ファイルは、書き込みはできても読み返しはできない設計です。
Dockerバックエンドを使う場合は、--cap-drop ALLで権限を落とし、プロセス数も256に制限されます。
Hermes Agentに関するよくある質問
Hermes Agentに関するよくある質問をまとめました。
- Hermes AgentはRAGに対応していますか?
-
公式ドキュメントに「RAG」という語は使われていません。
MCP経由の外部接続と、スキルによる学習型のナレッジ管理が、最も近い機能です。
- Nous HermesモデルとHermes Agentは同じものですか?
-
別物です。Nous Hermesはモデル、Hermes Agentはそれを動かすエージェントソフトです。
- Ollamaでコンテキスト長が足りない場合はどうすればいいですか?
-
環境変数
OLLAMA_CONTEXT_LENGTHやModelfileで、64,000トークン以上に設定し直します。 - 無料で商用利用できますか?
-
Hermes Agent自体はMITライセンスで、商用利用・改変・再配布に制限はありません(2026年10月確認)。
接続するモデル側のライセンスは、別途モデルごとに確認してください。
- バージョンはどのくらいの頻度で更新されますか?
-
執筆時点の最新版はv0.21.6(2026-10-08公開)で、3〜7日おきに更新されています。
手順を試す前に、
hermes updateで最新化しておくのが安全です。
まとめ|Hermes AgentをローカルLLMで動かす前に確認すること
Hermes AgentをローカルLLMで動かす前に確認すべき点を、ここまでの内容から整理しました。
正体:Hermes Agentは自律型エージェントソフトで、Nous Hermesモデルとは別物です。
接続条件:どのバックエンドでも、コンテキスト長64,000トークン以上を求められます。
公式窓口:公式はhermes-agent.nousresearch.comとGitHubのみで、他は非公式です。
機能の正体:「RAG対応」ではなく、MCP接続とスキルによる学習型のメモリです。
バージョン:更新が速いため、試す前にhermes updateで最新化してください。
公式情報は数日単位で更新されるため、手順通りに進まない場合はまず公式Releasesで最新状況を確認します。
接続先のツール選びやモデル選定で迷ったら、以下もあわせて確認してみてください。
- OllamaとLM Studioの違い:接続前にどちらを使うか迷ったら確認できます
- ローカルLLMおすすめモデル比較:繋ぐモデルそのものを選ぶときに使えます
- VRAM別に動かせるモデル一覧:搭載VRAMから動かせるモデルクラスを判断できます
- ローカルLLMの活用方法(カテゴリトップ):他の活用例もまとめて確認できます
参考資料
Hermes Agent公式サイト
Hermes Agent公式GitHub
Ollama公式サイト
LM Studio公式サイト

コメント