 悩んでる人
電源もメモリも、上のグレードにしとけば安心だよね……?
 情シス あおい
実は、ローカルLLM用途では「盛っても効果が薄い項目」がはっきり分かれています。
BTOの注文画面には、GPU・メモリ・電源・ストレージ・ケースまで選択肢が並んでいます。
迷ったら上のグレードを選んでおけば安心、という考え方は、効果の薄い項目にまで費用をかけることにつながりやすいです。
とはいえ、どの項目がローカルLLMの動作に効くのかは、公式情報を確認しないと判断できません。
そこで、BTOメーカー各社の公式情報と実際の注文画面を照らし合わせれば、効く項目と効かない項目の線引きが見えてきます。
今回は、注文画面の代表的なカスタマイズ項目を、ローカルLLM用途で効くかどうかで仕分けます。
- GPU(VRAM)・システムメモリ・電源のうち、注文画面で本当に「盛る」価値がある項目
- ケース冷却やCPUグレードのように、公式の定量データがなく判断が難しい項目
- ドスパラの実際の注文画面(1社1機種の実例)で、どこまで選択肢が用意されているか
BTOを実際に注文した経験は書いていません。公式ページと実際の注文画面の記載に基づいて整理しています。
先に結論を知りたい方は、BTO買いすぎ注意報から読んでも大丈夫です。
ローカルLLM BTO|注文画面で「全部盛り」にしない考え方
注文画面のオプションが多いのは、迷わせるためではありません。用途によって、必要な項目が人それぞれ変わるためです。
選択肢の多さは「迷わせる罠」ではない
用途が決まれば、そのまま「効く項目」も決まります。
逆に言えば、用途が決まる前に高いグレードを選んでも、効果を発揮しない項目に費用をかけることになりかねません。
効く項目と効かない項目を先に仕分ける
この記事では、GPU(VRAM)・システムメモリ・電源・ストレージ・ケース冷却・CPUの5項目を扱います。
「効く」「確認するだけでいい」「定性的にしか言えない」の3段階に仕分けます。選ぶ前に、今から何を確認すればいいかがわかる状態を目指します。
この記事の実例はドスパラ1社1機種(実機注文経験なしを明記)
実際の注文画面まで確認できたのは、ドスパラのGALLERIA VSA7C-R56Tという1機種だけです。
BTOを実際に注文した経験はなく、公式の商品ページと注文画面の記載を確認した範囲で書いています。他のメーカーや機種でも同じ選択肢があるとは限りません。
どのメーカー・どの機種を選ぶかは、ローカルLLM PCおすすめの記事で既に整理しています。この記事では、選んだあとの注文画面に絞ります。
GPU(VRAM)|ローカルLLM BTOで最優先すべき項目
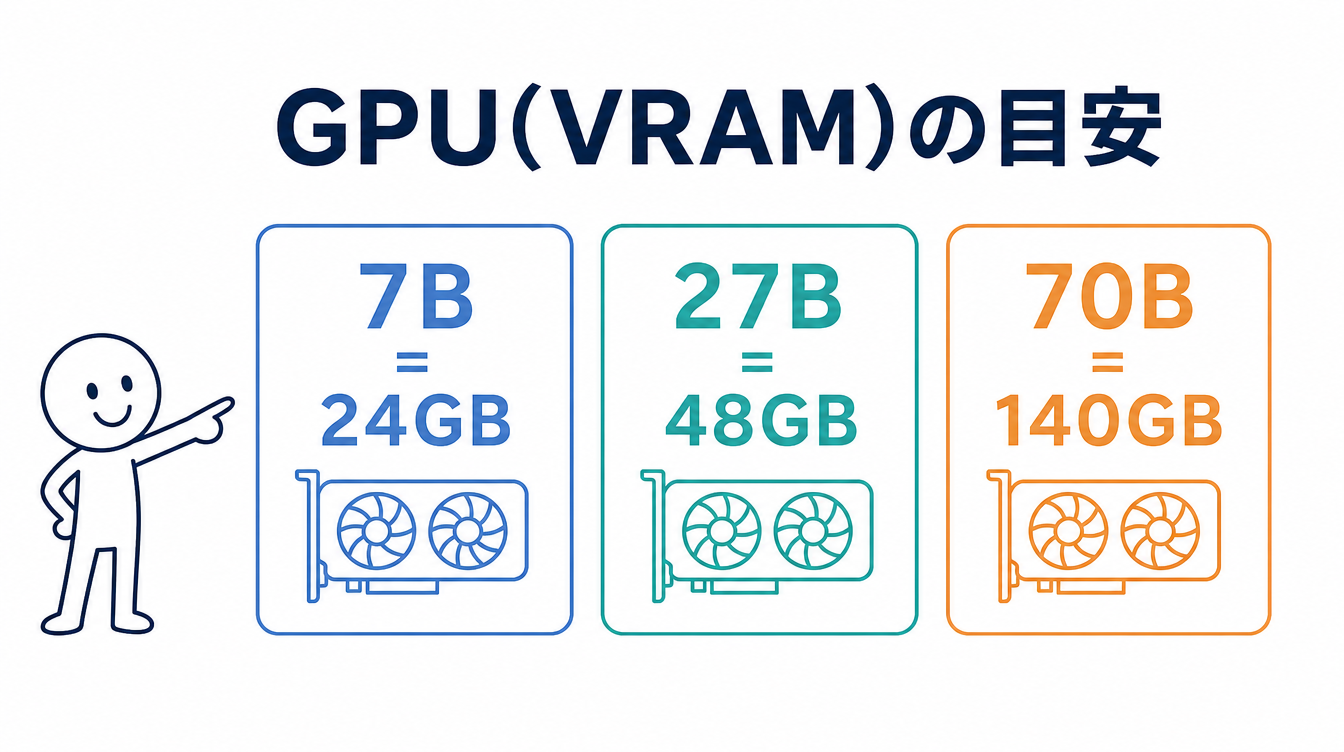
GPU(VRAM)は、5項目のうち最も効果がはっきりしている項目です。動かしたいモデルのサイズが、必要なVRAM容量をほぼそのまま決めます。
モデルサイズ別のVRAM目安(パソコン工房公式基準)
パソコン工房のLLM向けワークステーションページは、モデルサイズ別のVRAM目安を公式に示しています。
| モデルサイズ | 目安VRAM容量 |
|---|---|
| 7Bクラス | 24GB以上 |
| 27Bクラス | 48GB以上 |
| 70Bクラス | 140GB以上 |
パソコン工房公式の記載に基づく目安です(2026年8月15日確認)。動かしたいモデルの候補は、VRAM別モデル早見表の記事で確認できます。
コンシューマー向けGPUとプロ向けGPUの違い
パソコン工房公式は、GeForceやRadeonなどのコンシューマー向けGPUに言及しています。
長時間稼働時の安定性で、RTX PRO・Radeon AI PROに劣るという見解です。
これはBTOベンダー独自の見解であり、NVIDIA・AMD自身が公式に明言しているわけではありません。
マルチGPU構成という選択肢(TSUKUMO実例)
TSUKUMOのマルチGPU特設ページでは、GPU2枚構成でVRAM容量を合算する構成を選べます。
NVIDIA RTX PROシリーズやGeForce RTX 5060 Ti、AMD Radeon AI PRO R9700まで選べます。
型番単位で選択肢が用意されていることを確認しました(2026年8月15日確認)。
単体GPUの基本的な選び方は、GPUおすすめの記事に譲ります。この記事では、BTOの注文画面での扱いに絞ります。
システムメモリ|「VRAMの2倍」という目安の使い方
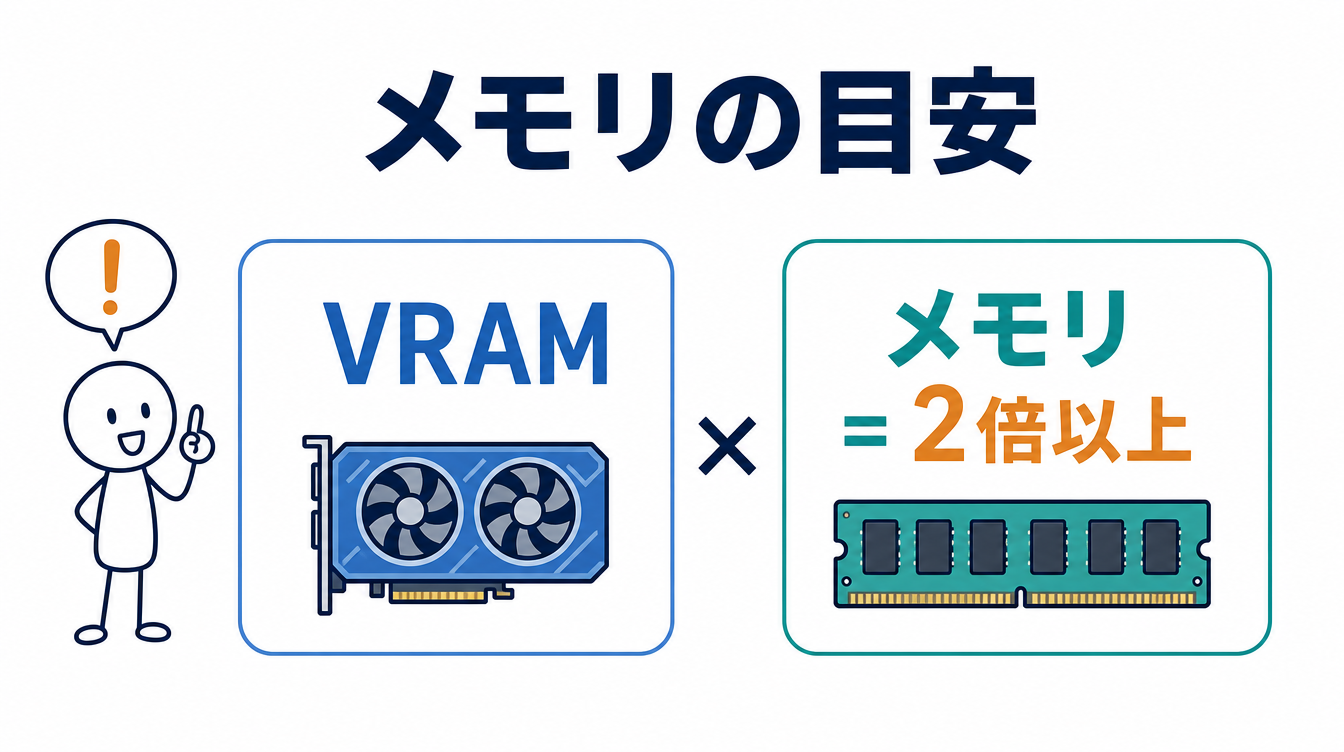
システムメモリは、GPU(VRAM)ほど絶対的ではないものの、CPUオフロードの仕組み上、効果が期待できる項目です。
「VRAMの2倍以上」はパソコン工房独自の目安
パソコン工房公式は、搭載するVRAM容量の2倍以上のメモリ搭載を推奨値として明記しています。
この倍率は、パソコン工房という一BTOベンダーの推奨値です。NVIDIA・AMD・ツール開発元が定めた公式ルールではありません。
CPUオフロードとメモリの関係(llama.cpp公式の仕組み)
llama.cpp公式は、VRAMに載り切らない分をCPU側へ振り分ける、CPU+GPUハイブリッド推論の仕組みを示しています。
システムメモリは、この振り分け先の受け皿です。VRAMを使い切っても、メモリに余裕があれば実行そのものは続けられます。
メモリは32GB→64GB→128GBの3段階で選べる
ドスパラの実際の注文画面では、メモリを32GB→64GB→128GBと引き上げる選択肢がありました(1社1機種の実例です)。
一段引き上げるごとに、その差はさらに大きくなる設計です。
機械的に大容量を選ぶのではなく、動かしたいモデルサイズから逆算して、必要な分だけ積むのが現実的です。
必要なメモリ量の考え方は、必要メモリの決め方の記事で実測を交えて解説しています。
電源(PSU)|見落とされがちな必須確認項目
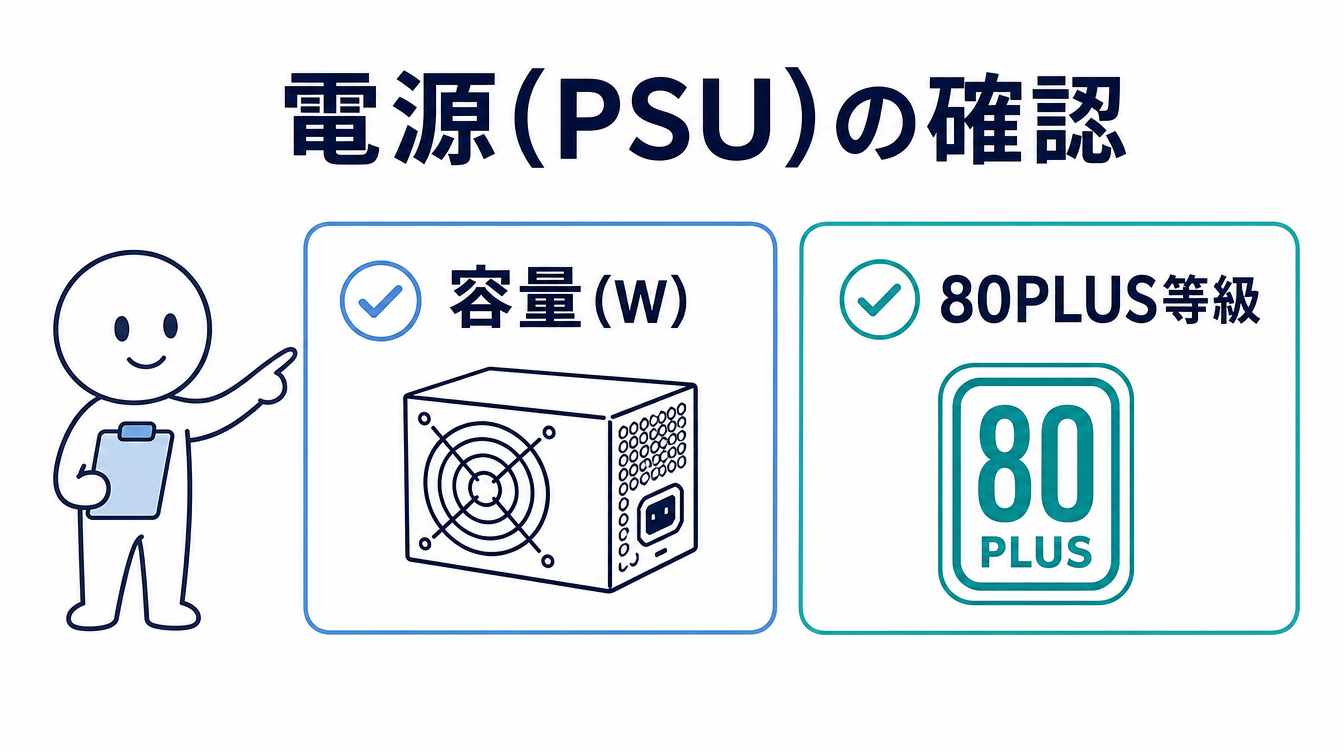
電源は「盛る」項目ではありません。GPUの必要システム電源を満たしているかを確認する項目です。
まず確認すべきはGPUの必要システム電源
NVIDIA公式は、GPUクラスごとに必要なシステム電源を示しています。
| GPU | 必要システム電源 |
|---|---|
| GeForce RTX 5060 Ti | 600W |
| GeForce RTX 5070 Ti | 750W |
| GeForce RTX 5090 | 1000W |
80PLUS認証グレードは容量と別軸の指標
80PLUS(BRONZE〜PLATINUM)やCybeneticsなどの認証グレードは、電源変換効率と静音性を示す指標です。
GPUの動作に必要な「容量(W)」とは、そもそも別の軸の話です。容量さえ満たせば、グレードは静音性や電気代への投資として選べます。
標準の650Wでも、GeForce RTX 5060 Ti(16GB)には足りる
ドスパラの実際の注文画面では、標準の650W(80PLUS BRONZE)から選択肢が始まります。
上位は1000W(80PLUS PLATINUM)や、さらに上位のCybenetics認証グレードまで用意されていました(1社1機種の実例です)。
標準構成の650W(BRONZE)は、GeForce RTX 5060 Ti(16GB)の必要システム電源600Wを、50Wの余裕を持って満たしていました。
ストレージ・ケース冷却・CPU|数値で語れない項目
ストレージは必要容量を逆算できる一方、ケース冷却とCPUグレードのLLM推論への定量効果は、公式の数値情報が見つかりませんでした。
ストレージ容量はモデルファイルサイズから逆算する
Hugging Faceの実測では、量子化モデルのファイルサイズは、7B級で4〜5GB、12B級で6.8GB、20B級で11.3GB程度でした。
パソコン工房公式は、メインストレージに1TB以上のNVMe SSDを推奨しています。複数モデルを扱うなら、2台目以降にも1TB以上を追加する想定です。
ケース冷却は「安定稼働」への寄与にとどまる
ここから先は、公式の定量データがありません。
ケース冷却とCPUグレードが推論速度に与える影響を示す、GPU/CPUベンダーの公式ベンチマークは見つかりませんでした。
- ケース冷却で言えること:高負荷時の安定稼働への寄与
- ケース冷却で言えないこと:推論速度への定量的な効果
- CPUで言えること:モデルサイズ別の推奨グレード(パソコン工房公式)
- CPUで言えないこと:具体的な速度差の数値
パソコン工房公式は、冷却性能の高いケースとクーラーの組み合わせにより、高負荷時も長時間安定して動作するとしています。
CPUグレードはモデルサイズ別の目安がある(パソコン工房公式)
パソコン工房公式は、モデルサイズ別にCPUグレードの目安を示しています。
- 7Bクラス:Core Ultra 7/Ryzen 7以上
- 27Bクラス:Core Ultra 9/Ryzen 9以上
- 70Bクラス:Xeon/Threadripper以上
この目安は、パソコン工房公式が示しているものです(2026年8月15日確認)。
モデルの読み込みや並列処理への影響は説明されていますが、具体的な速度差の数値は示されていません。
NVMe Gen4とGen5の速度差は読み込み時間への影響が未確認
NVMe Gen4とGen5には、公称の理論転送速度に差があります。
ただし、その差がモデルの読み込み時間をどれだけ短縮するかを示す公式情報は見つかりませんでした。
「LLM向けにはGen5が有利」という断定は避け、必要な容量から選ぶのが現実的です。
BTO買いすぎ注意報|盛る項目と確認だけでいい項目
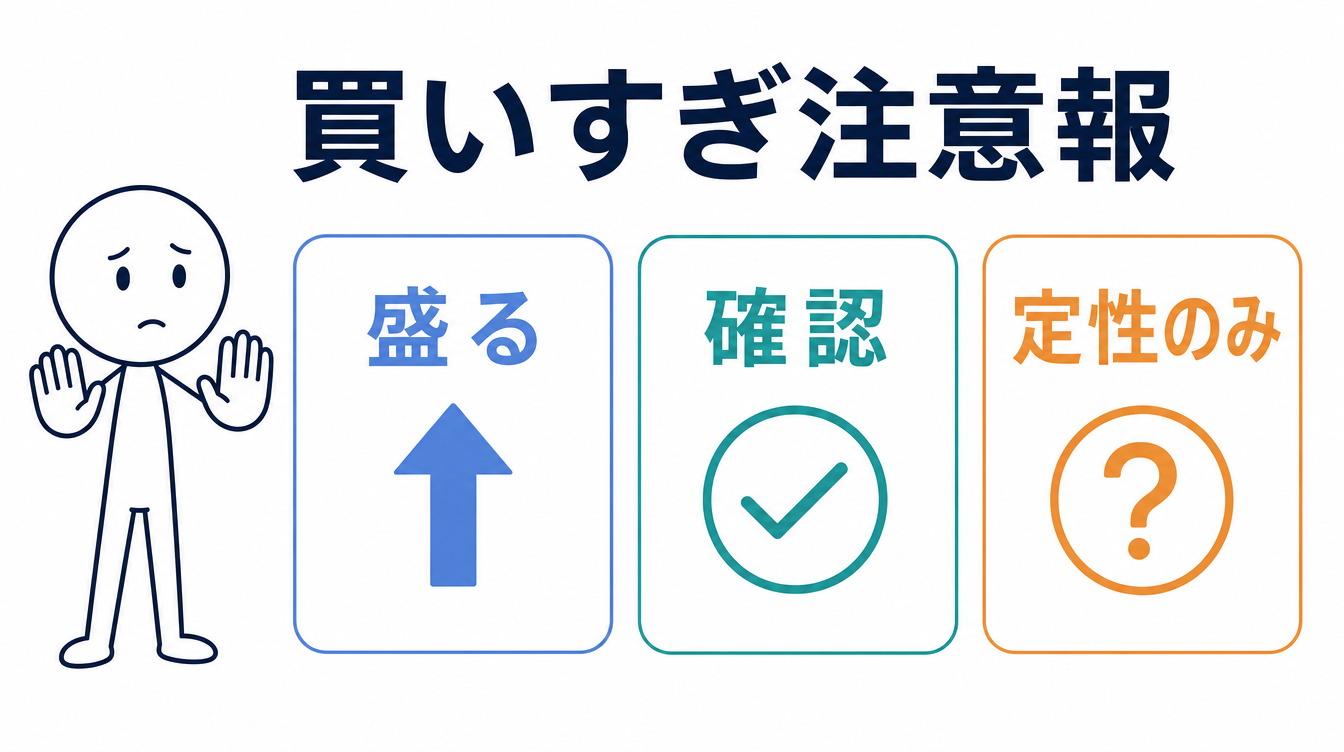
ここまでの5項目を、盛るべき/確認だけでいい/定性的にしか言えない、の3段階で整理すると、判断はぐっとシンプルになります。
盛るべき項目|GPU(VRAM)とシステムメモリ
GPU(VRAM)とシステムメモリは、動かしたいモデルのサイズにそのまま比例して効果が出る項目です。用途から逆算して、積極的に盛る価値があります。
確認だけでいい項目|電源とストレージ
電源とストレージは、GPUの必要システム電源やモデルファイルの容量に足りているかを確認すればいい項目です。上位グレードにしても、動作そのものは速くなりません。
定性的にしか言えない項目|ケース冷却とCPU
ケース冷却とCPUグレードは、長時間の安定稼働という意味では効きます。
ただし、推論速度への定量的な効果は公式に示されていません。過度に高いグレードを追う必要はないでしょう。
盛る:GPU(VRAM)・システムメモリ。
確認だけ:電源(PSU)・ストレージ。
定性的にしか言えない:ケース冷却・CPU。
高い専用機を買う前に、手元のマシンで試す価値は十分にあります。
MacでローカルLLMを動かす方法の記事では、専用機を用意する前に、手元のPCでどこまで動くかを確認しています。
ローカルLLM BTOカスタマイズのよくある質問
BTOのカスタマイズ項目について、よくある質問をまとめました。
- BTOのメモリは購入後に増設できる?
-
機種によって異なります。パソコン工房の実測では、コンシューマー向け機種はメモリに「変更可」の表示がありました。
一方、ECC Registered DIMMを搭載するワークステーション機種は、工場出荷時に固定され変更できませんでした。
購入前に、商品ページの表示を確認してください。
- 電源グレードは高いほうがいい?
-
動作の必須条件ではありません。まず確認すべきはGPUの必要システム電源(容量W)です。
80PLUSなどの認証グレードは、電力効率や静音性を左右する別軸の指標です。容量を満たしていれば、グレードは好みで選んで問題ありません。
- NVMe Gen5にする価値はある?
-
理論上の転送速度はGen4より高いものの、モデル読み込み時間をどれだけ短縮するかを示す公式情報は見つかりませんでした。
速度を目的にGen5を選ぶ根拠は今のところ弱く、必要な容量から選ぶほうが現実的です。
まとめ|ローカルLLM BTOは効く項目から盛る
ローカルLLM用BTOの注文画面について、ここまでの内容を整理します。
GPU(VRAM):動かしたいモデルサイズにそのまま比例する、最優先で盛るべき項目です。
システムメモリ:CPUオフロードの受け皿として効きますが、「VRAMの2倍以上」は一BTOベンダーの目安です。
電源(PSU):盛る項目ではなく、GPUの必要システム電源を満たしているか確認する項目です。
ストレージ・ケース冷却・CPU:容量は逆算できますが、冷却とCPUグレードの推論速度への定量効果は未確認です。
今日確認する1つのことがあるとすれば、動かしたいモデルのサイズから逆算した必要VRAM容量です。そこが決まれば、残りの項目は確認するだけで済みます。
高い専用機を買う前に、手元のマシンで試す価値は十分にあります。
注文画面の項目が整理できたら、あわせて次の記事も確認してみてください。
- ローカルLLM PCおすすめ:どのメーカー・機種を選ぶかをまとめています
- ローカルLLM GPUおすすめ:対応ツールと電源要件で選ぶ基本を解説しています
- ローカルLLM VRAM別早見表:容量クラスごとに動くモデルを一覧できます
- ローカルLLMに必要なメモリの決め方:実測を交えて必要量を解説しています
- ローカルLLMをMacで動かす方法:専用機の前に、まず手元のPCで試す方法です
- ローカルLLMのスペック(カテゴリトップ):BTO・GPU関連の記事をまとめています


コメント